Feed-Archive für eine persönliche Website - Geschichte bewahren, ohne Paginierung für vollständig zu halten
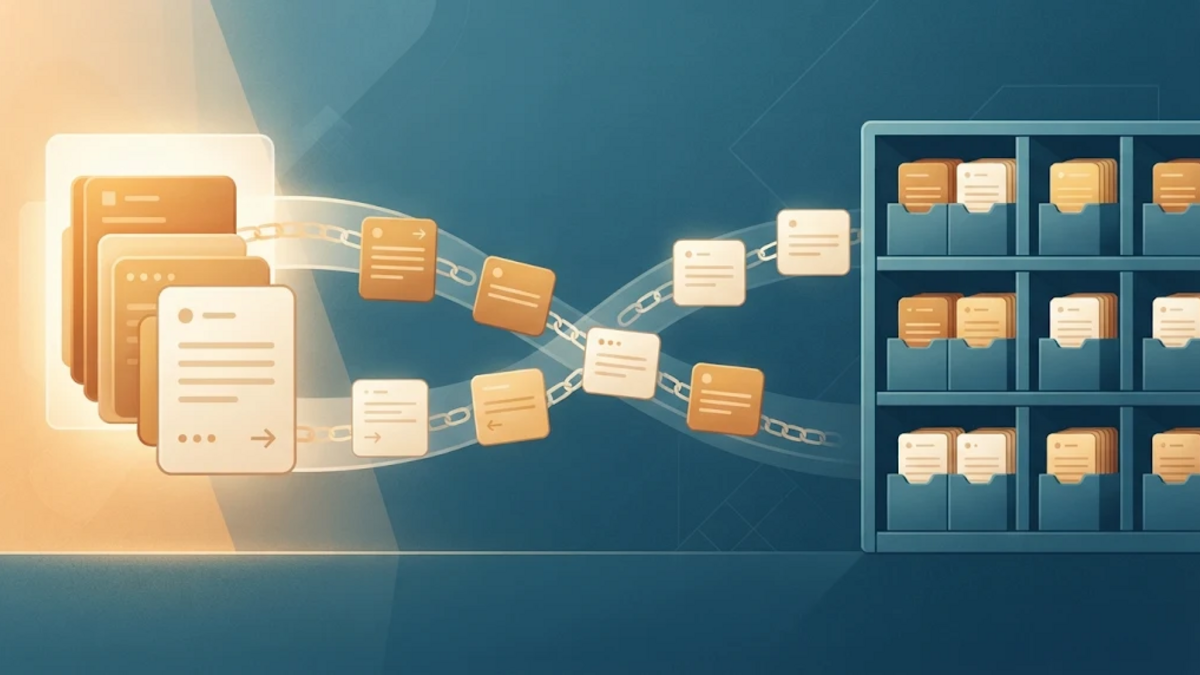
Eine persönliche Website kann Hunderte Beiträge veröffentlichen, während ihr Feed nur die neuesten zwanzig zeigt. Für regelmäßige Abonnenten reicht das oft aus, doch eine schwierige Frage bleibt: Bietet der Feed einem Leser, der spät hinzukommt oder mehrere Aktualisierungen verpasst, einen definierten Weg zu älteren Einträgen, oder zeigt er lediglich ein bewegliches Fenster?
?page=2 hinzuzufügen, wirkt wie eine naheliegende Antwort. Paginierung allein sagt jedoch nicht, ob die zweite Seite morgen dieselben Einträge enthält, ob ein Client die Geschichte der Website rekonstruieren kann oder ob ein fehlender Eintrag als gelöscht gelten soll. RFC 5005, Feed Paging and Archiving, trennt diese Fragen durch die Definition vollständiger, paginierter und archivierter Feeds. Die Unterscheidungen sind alt, doch die publizistische Frage bleibt nützlich: Welches Versprechen gibt jedes Feed-Dokument über die größere Sammlung ab?
Ein Feed-Dokument ist nicht unbedingt der gesamte Feed
RFC 5005 unterscheidet ein Feed-Dokument von einem logischen Feed. Ein Dokument ist eine einzelne Atom-Datei oder ein ähnliches Syndikationsdokument, das von einer URL abgerufen wird. Der logische Feed ist die vollständige Menge der damit verbundenen Einträge. Ein Dokument kann die gesamte Menge, einen vorübergehenden Ausschnitt oder einen stabilen Teil eines Archivs darstellen.
Das ähnelt einem Bibliothekskatalog, der jeweils nur einen Bildschirm zeigt. Ein Bildschirm ist eine Darstellung des Katalogs, nicht automatisch der Katalog selbst. Bevor Software Seitenlinks folgt, muss sie wissen, ob diese Bildschirme sich verschiebende Suchergebnisse oder dauerhafte Regale sind.
Atom selbst erlaubt einem Feed-Dokument, einige oder alle zugehörigen Einträge zu enthalten, lässt die Einzelheiten der Rekonstruktion jedoch außerhalb seines Geltungsbereichs. RFC 5005 ergänzt ein Vokabular für diese fehlende Beziehung. Er verpflichtet nicht jedes Blog, seine gesamte Geschichte zu veröffentlichen, und macht einen gewöhnlichen Feed mit aktuellen Beiträgen nicht zu einem Fehler.
Drei Modelle geben unterschiedliche Versprechen
Vollständige Feeds: Dieses Dokument ist die Menge
Ein vollständiger Feed erklärt ausdrücklich, dass ein Dokument jeden Eintrag des logischen Feeds enthält. Er verwendet das leere Element fh:complete aus dem Feed-History-Namensraum. Fehlt ein Eintrag, sollte ein Consumer ihn nicht als Teil dieses logischen Feeds betrachten.
<feed xmlns="http://www.w3.org/2005/Atom"
      xmlns:fh="http://purl.org/syndication/history/1.0">
  <title>Example Reading List</title>
  <fh:complete />
  <!-- every entry in this logical feed -->
</feed>
Das kann zu einer begrenzten Sammlung wie einer aktuellen Leseliste passen. Für ein Blog mit stetig wachsender Geschichte ist es meist weniger geeignet. Vor allem ist die Markierung eine Aussage über Vollständigkeit und keine dekorative Erweiterung. Ein Publisher sollte sie nicht einem Fenster mit zwanzig Einträgen hinzufügen, nur weil dieses Dokument gültiges Atom ist.
Paginierte Feeds: Navigation ohne stabile Geschichte
Ein paginierter Feed verteilt Einträge auf verknüpfte Dokumente und verwendet Beziehungen wie first, last, previous und next. Nach RFC 5005 muss in einem paginierten Feed-Dokument mindestens eine dieser Beziehungen vorhanden sein; so viele anwendbare Beziehungen wie praktisch möglich sollten angegeben werden.
Der entscheidende Vorbehalt lautet, dass die Inhalte der Seiten nicht stabil bleiben müssen. Angenommen, Seite eins enthält die Beiträge 101 bis 110 und Seite zwei die Beiträge 91 bis 100. Ein neuer Beitrag, der eingefügt wird, während ein Client die Seiten durchläuft, kann die Grenze verschieben. Der Client könnte einen Eintrag doppelt sehen und einen anderen verpassen. RFC 5005 bezeichnet paginierte Feeds deshalb als verlustbehaftet und sagt, Clients sollten sie nicht als kohärent oder vollständig darstellen.
Das macht Paginierung nicht nutzlos. Sie ist geeignet, wenn ein Client einen beliebigen benachbarten Ausschnitt benötigt und exakte Rekonstruktion nicht das Ziel ist. Der Fehler besteht darin, eine bewegliche Liste allein deshalb Archiv zu nennen, weil Nutzer immer weiter auf „next“ klicken können.
Archivierte Feeds: stabile Teile mit Verbindung zur Gegenwart
Ein archivierter Feed ist so gestaltet, dass seine Dokumente kombiniert werden können, um den logischen Feed genau zu rekonstruieren. Er besitzt ein Abonnementdokument mit den neuesten hinzugefügten oder geänderten Einträgen und ein oder mehrere Archivdokumente mit älteren Einträgen.
Das Abonnementdokument verweist mit prev-archive zurück. Archivdokumente können diese Kette fortsetzen, mit next-archive nach vorn verweisen und mit current das aktuelle Abonnementdokument bezeichnen. Das IANA-Register der Link Relations führt diese Beziehungen und ihre Definitionen aus RFC 5005 weiterhin auf.
Wie ein kleines Atom-Archiv aussehen kann
Die folgenden Ausschnitte dienen der Veranschaulichung und sind keine Aussage über die heutige Unterstützung durch Feedreader. Das aktuelle Abonnementdokument stellt neue Einträge bereit und verweist auf das neueste abgeschlossene Archiv:
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>Example Notes</title>
  <link rel="self" href="https://example.com/feed.atom" />
  <link rel="prev-archive"
        href="https://example.com/feed/archive/2026-10.atom" />
  <id>https://example.com/feed.atom</id>
  <updated>2026-11-08T00:00:00Z</updated>
  <!-- newest entries -->
</feed>
Ein abgeschlossenes Oktober-Archiv kennzeichnet sich als Archiv, verweist auf das aktuelle Abonnementdokument und verlinkt optional benachbarte abgeschlossene Archive:
<feed xmlns="http://www.w3.org/2005/Atom"
      xmlns:fh="http://purl.org/syndication/history/1.0">
  <title>Example Notes - October 2026 Archive</title>
  <link rel="self"
        href="https://example.com/feed/archive/2026-10.atom" />
  <link rel="current" href="https://example.com/feed.atom" />
  <link rel="prev-archive"
        href="https://example.com/feed/archive/2026-09.atom" />
  <fh:archive />
  <id>https://example.com/feed/archive/2026-10.atom</id>
  <updated>2026-10-31T23:59:59Z</updated>
  <!-- stable archived entries -->
</feed>
RFC 5005 sagt, dass ein Abonnement- oder Archivdokument prev-archive enthalten muss, sofern kein früheres Archiv verfügbar ist. Ein Archiv sollte next-archive enthalten, wenn ein späteres abgeschlossenes Archiv existiert, sollte das Abonnementdokument mit current bezeichnen und sollte fh:archive enthalten. Diese unterschiedlichen Formulierungen sind wichtig: Die Spezifikation verleiht nicht jedem Feld dieselbe Verbindlichkeit.
Stabilität ist der zentrale Vertrag des Archivs
RFC 5005 sagt, dass sich die Einträge unter einer bestimmten Archiv-URL und die URL selbst im Laufe der Zeit nicht ändern sollten. Diese Stabilität erlaubt einem Consumer, sich zu merken, dass er ein Archiv bereits verarbeitet hat, statt es wiederholt herunterzuladen und abzugleichen.
Ein datumsbasierter Pfad kann die Struktur verständlich machen, doch das Datum erzeugt nicht von selbst Stabilität. Ein CMS, das alte Monatsdateien nach jeder Bearbeitung mit anderen Grenzen neu erstellt, verletzt weiterhin diese Erwartung. Die praktische Designfrage lautet, wo die Archivgrenze festgehalten wird. Ein dauerhaftes Archiv benötigt eine gespeicherte Mitgliedschaftsregel oder einen anderen deterministischen Mechanismus, der Einträge nicht unbemerkt zwischen Dokumenten verschiebt.
Das erklärt auch, warum ein noch entstehendes Archiv nicht so verknüpft werden sollte, als wäre es abgeschlossen. Im Beispiel von RFC 5005 besitzt das neueste fertige Archiv keinen next-archive-Link zum laufenden Monat. Das aktuelle Abonnementdokument enthält neue Änderungen, bis ein Archiv als stabil behandelt werden kann.
Korrekturen erschweren Unveränderlichkeit
„Stabil“ bedeutet nicht, dass sachliche Fehler für immer erhalten bleiben müssen. Der RFC erkennt einen Zielkonflikt an: Manche Clients besuchen ein bereits verarbeitetes Archiv möglicherweise nicht erneut. Wenn eine Korrektur die Consumer erreichen muss, sollte der Publisher erwägen, den überarbeiteten Eintrag auch im Abonnementdokument bereitzustellen, statt ausschließlich das alte Archiv zu ändern.
Dieses Verhalten hängt von dauerhafter Eintragsidentität ab. In Atom-Archiven sind Einträge mit derselben atom:id Duplikate. Ein Consumer sollte den Eintrag mit dem neuesten atom:updated behalten. Lösen Zeitstempel die Auswahl nicht, erhält nach der Anleitung von RFC 5005 der Eintrag aus dem zuletzt aktualisierten Feed-Dokument Vorrang.
Dadurch wird nicht jede Korrektur in jedem Client zuverlässig sichtbar. Es definiert ein Rekonstruktionsmodell für konforme Consumer. Ein Publisher kann die heutige Softwareunterstützung weiterhin nicht aus Alter oder Status des Standards ableiten; jedes produktspezifische Versprechen erfordert echte Interoperabilitätstests.
Ein Consumer muss der Kette misstrauen
Eine Archivkette ist Eingabe aus dem Netzwerk und keine vertrauenswürdige verkettete Liste. Ein Dokument kann in eine Schleife verweisen, zu einem nicht verfügbaren Archiv führen oder eine praktisch endlose Folge von Anfragen erzeugen. RFC 5005 warnt vor übermäßigen Anfragen und Ressourcenverbrauch. Ein sorgfältiger Consumer benötigt Grenzen für Dokumente, Bytes, Zeit, Weiterleitungen und bereits gesehene URLs.
Fehlt ein Archiv, kann der Consumer den logischen Feed möglicherweise nicht rekonstruieren. Die Spezifikation sagt, Clients sollten Nutzer informieren, wenn die Rekonstruktion unvollständig ist. Eine teilweise Geschichte stillschweigend als vollständig zu zeigen, würde genau die Unterscheidung beseitigen, die das Archivmodell ausdrücken soll.
Die normale Feed-Hygiene gilt weiterhin. Atom-Dokumente müssen wohlgeformt bleiben, ihre Eintrags-IDs müssen stabil sein und Zeitstempel ihre beabsichtigte Bedeutung behalten. Die W3C-Seite Introduction to Atom ist eine nützliche strukturelle Checkliste, während RFC 4287 die maßgebliche Formatspezifikation bleibt.
Wann ein Feed mit aktuellen Einträgen ausreicht
RFC 5005 ist keine Voraussetzung für den Betrieb eines seriösen Blogs. Ein gewöhnlicher Feed mit aktuellen Einträgen ist oft die bessere Wahl, wenn Leser nur Aktualisierungen benötigen, das HTML-Archiv bereits die Navigation ermöglicht und kein bekannter Consumer eine maschinell rekonstruierbare Feed-Geschichte braucht.
Ein archivierter Feed ist eher vertretbar, wenn das Fehlen alter Einträge reale Kosten verursacht, stabile Archivdateien gepflegt werden können und mindestens ein Ziel-Consumer bekannt ist, der den Beziehungen korrekt folgt. Ein paginierter Feed passt zur Erkundung, wenn verschobene Grenzen akzeptabel sind. Ein vollständiger Feed passt zu einer tatsächlich begrenzten Menge. Die Wahl sollte mit der Semantik beginnen und nicht mit dem URL-Muster, das am einfachsten zu erzeugen ist.
Vor dem Hinzufügen von Archivlinks kann ein Publisher fragen:
- Ist das Ziel die Navigation in der Nähe oder eine verlässliche Rekonstruktion?
- Können URL und Mitgliedschaft jedes abgeschlossenen Archivs stabil bleiben?
- Kehren wichtige Korrekturen mit derselben Eintrags-ID in das Abonnementdokument zurück?
- Können defekte Links und eine unvollständige Geschichte erkannt statt verborgen werden?
- Wurde der vorgesehene Reader oder das nachgelagerte Werkzeug tatsächlich getestet?
Fazit
Ein über mehrere URLs verteilter Feed ist nicht automatisch ein Archiv. Paginierte Feeds bieten Navigation durch veränderliche Ausschnitte; archivierte Feeds versprechen stabile Teile, die zusammengesetzt werden können; vollständige Feeds erklären ein Dokument zur gesamten logischen Menge. Jedes Modell beantwortet eine andere Frage.
Für eine kleine persönliche Website kann der einfachste Feed mit aktuellen Einträgen weiterhin völlig ausreichen. Wird eine dauerhafte maschinenlesbare Geschichte zur Anforderung, bietet RFC 5005 mehr als zusätzliche Links: Er bietet ein Vokabular, um ihre Bedeutung auszudrücken. Der schwierige Teil ist nicht, prev-archive auszugeben. Er besteht darin, die dahinterstehenden Versprechen zu Stabilität und Korrekturen einzuhalten.