Idempotency Keys für kleine PHP-APIs - Die Operation wiederholen, nicht den Nebeneffekt
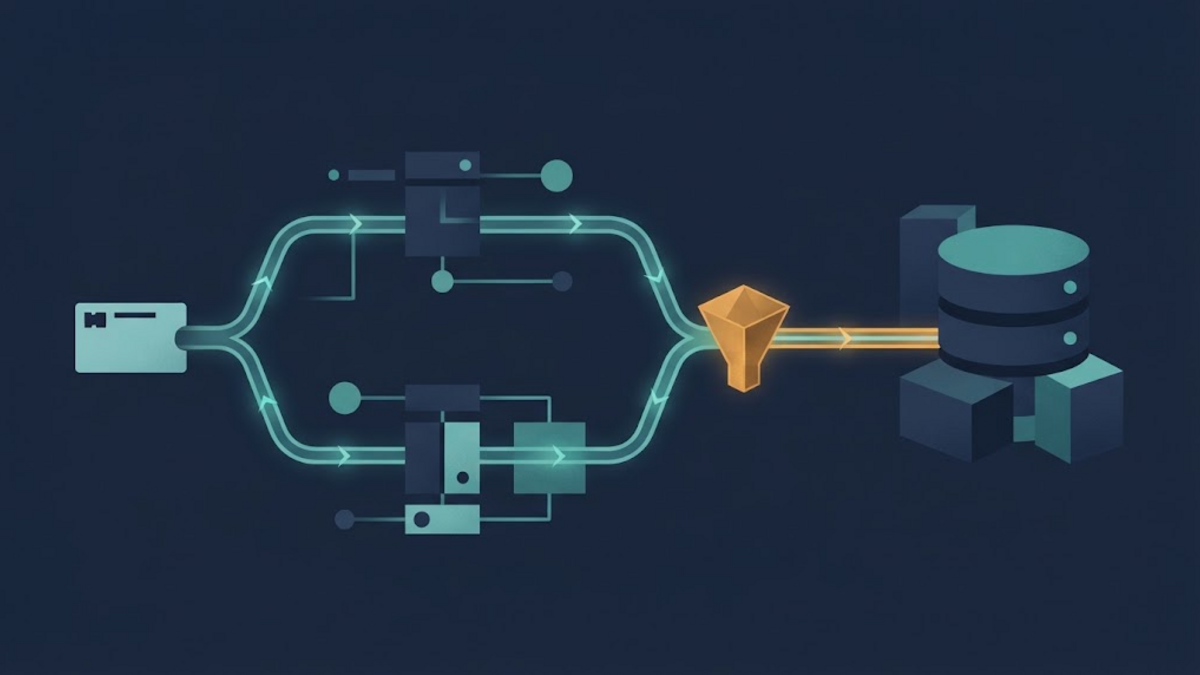
Ein Client sendet POST /orders. Der Server hat die Bestellung möglicherweise bereits festgeschrieben, doch die Antwort geht während eines Timeouts verloren. Soll der Client den Request wiederholen? Dann könnte er eine zweite Bestellung anlegen. Verzichtet er darauf, bleibt der Benutzer womöglich ganz ohne Bestellung.
Das ist nicht nur eine Frage der Retry-Syntax, sondern eine Frage der Identität: Wie kann der Client ausdrücken, dass dies ein weiterer Versuch derselben Operation ist? Und wie kann der Server sich diese Entscheidung über parallele Requests und Prozessneustarts hinweg merken?
Ein Idempotency Key ist eine mögliche Antwort. Er kann einen unsicheren Retry beherrschbar machen, doch der Header allein garantiert nichts. Eine belastbare Zusage entsteht erst durch einen dokumentierten Vertrag, einen maßgeblichen Datenspeicher und eine atomare Grenze, die sowohl den Key als auch die fachliche Änderung umfasst.
HTTP-Idempotenz und die Idempotenz einer Operation liegen auf verschiedenen Ebenen
RFC 9110 bezeichnet eine HTTP-Methode als idempotent, wenn mehrere identische Requests dieselbe beabsichtigte Wirkung haben wie ein einzelner Request. PUT und DELETE besitzen idempotente Semantik; für POST gibt es diese allgemeine Zusage nicht. Das bedeutet nicht, dass eine idempotente Methode keinerlei Nebeneffekte hat. Ein Server kann jeden Request protokollieren, und wiederholte Antworten müssen nicht Byte für Byte identisch sein.
Eine Anwendung kann einer bestimmten POST-Operation dennoch einen Retry-Vertrag geben. Der Client erzeugt eine eindeutige Operations-ID und sendet sie bei jedem Versuch. Der Server unterscheidet damit einen Retry von einer neuen Absicht:
POST /orders HTTP/1.1
Content-Type: application/json
Idempotency-Key: "8e03978e-40d5-43e8-bc93-6894a57f9324"

{"product_id":42,"quantity":1}
Die oben gezeigte, in Anführungszeichen gesetzte Feldsyntax folgt dem aktuellen Vorschlag im Idempotency-Key-Entwurf der IETF HTTPAPI Working Group. Am 3. November 2026 liegt das Dokument als Draft 08 vor, veröffentlicht am 22. Oktober 2026. Es ist ein aktiver Internet-Draft und kein endgültiger RFC. Eine API kann das Muster bereits einsetzen, sollte aber nicht jedes Detail des Entwurfs als feststehendes Protokollrecht darstellen.
Die API braucht einen Vertrag, nicht nur einen Header-Namen
Ein Client kann nicht sicher erraten, wie ein unbekannter Server Idempotency-Key behandelt. Die API-Dokumentation sollte mindestens die folgenden Fragen beantworten:
- Welche Operationen akzeptieren oder verlangen einen Key?
- Welches Format und welche maximale Länge sind gültig?
- In welchem Geltungsbereich muss der Key eindeutig sein: Benutzer, API-Zugangsdaten, Tenant, Endpoint oder ein anderer Bereich?
- Wie lange wird das Ergebnis aufbewahrt?
- Was geschieht, wenn derselbe Key mit einem anderen Payload eintrifft?
- Was geschieht, solange der erste Versuch noch verarbeitet wird?
- Erhält ein abgeschlossener Retry eine gespeicherte oder eine neu erzeugte, gleichbedeutende Antwort?
- Welche Fehler darf der Client mit welcher Verzögerung erneut versuchen?
Diese Entscheidungen sind nicht universell. Stripe dokumentiert Parametervergleiche, Antwortspeicherung und Bereinigung für seine APIs. Adyen dokumentiert Account-Geltungsbereiche, ein Aufbewahrungsintervall, regionale Grenzen und das Verhalten bei vorübergehenden Fehlern. Diese Richtlinien zeigen produktiv eingesetzte Designs, sind aber keine Standardwerte, die jede kleine PHP-API übernehmen sollte.
Eine kleine Zustandsmaschine macht das Verhalten sichtbar
Ein Key innerhalb seines Geltungsbereichs lässt sich mit drei relevanten Zuständen modellieren:
- Absent: Es wurde noch keine passende Operation beansprucht. Ein Request darf den Key beanspruchen und die Arbeit beginnen.
- Processing: Ein Versuch besitzt den Key, aber ein endgültiges Ergebnis liegt noch nicht vor. Ein paralleles Duplikat darf die fachliche Operation nicht erneut starten.
- Completed: Für die Operation ist ein Ergebnis gespeichert. Ein späterer Retry erhält dieses oder ein semantisch gleichwertiges Ergebnis, ohne die Arbeit zu wiederholen.
Daneben gibt es einen ungültigen Übergang: Der Key existiert, doch der neue Request beschreibt eine andere Arbeit. Das ist kein Retry, sondern eine widersprüchliche Absicht, die klar abgelehnt werden sollte.
Eine konzeptionelle Tabelle könnte eine Tenant- oder Principal-ID, den Endpoint oder Operationsnamen, den Key, einen Request-Fingerprint, den Zustand, Antwortmetadaten, Zeitstempel und einen Ablaufzeitpunkt enthalten. Die entscheidende Datenbankregel ist ein Unique Constraint über den gewählten Geltungsbereich und den Key. Eine Abfolge aus „prüfen, dann einfügen“ in PHP reicht nicht: Zwei Worker können beide die Abwesenheit feststellen, bevor einer von ihnen einfügt. Die Datenbank muss entscheiden, welcher Request gewinnt.
Key und fachlicher Schreibvorgang benötigen eine atomare Grenze
Die gefährlichsten Lücken entstehen, wenn die Anwendung nur die halbe Wahrheit speichert:
- Speichert sie „completed“, bevor sie die Bestellung anlegt, kann ein Absturz eine Operation unterdrücken, die nie stattgefunden hat.
- Legt sie die Bestellung vor dem Key an, kann ein Absturz dazu führen, dass ein Retry eine weitere Bestellung erzeugt.
Wenn Idempotenz-Datensatz und fachlicher Datensatz in derselben relationalen Datenbank liegen, kann eine Transaktion den Key beanspruchen, die Bestellung schreiben und das Ergebnis mit einem einzigen Commit festhalten. Der Unique Constraint entscheidet konkurrierende Ansprüche. Nur in diesem begrenzten Fall bietet eine lokale Transaktion eine saubere Grenze.
Diese Grenze umfasst nicht automatisch einen E-Mail-Dienst, einen Zahlungsanbieter oder eine andere Datenbank. Ein MariaDB-Rollback kann eine bereits erfolgreiche externe Belastung nicht rückgängig machen. Solche Workflows benötigen ein zusätzliches Design: die Idempotenzfunktion des nachgelagerten Anbieters, eine Transactional Outbox, eine fortsetzbare Zustandsmaschine oder einen Abgleich anhand einer stabilen externen Operations-ID. Den äußeren Endpoint als „idempotent“ zu bezeichnen, darf die verbleibenden Fehlerfenster nicht verdecken.
Der AWS-Bericht über idempotentes API-Design beschreibt einen verwandten Punkt: Das Speichern des Request-Tokens und die verändernde Arbeit müssen eine Alles-oder-nichts-Grenze erfüllen. Er erklärt außerdem, warum eine vom Aufrufer bereitgestellte ID häufig eindeutiger ist als eine Vermutung anhand gleicher Parameter. Zwei Requests mit identischen Feldern können zwei absichtliche Bestellungen sein und nicht ein Duplikat derselben Bestellung.
Einen Fingerprint verwenden, um geänderte Absichten zu erkennen
Der Client-Key drückt Identität aus. Ein vom Server erzeugter Fingerprint prüft die Konsistenz. Der Server könnte beispielsweise Methode, Route, authentifizierten Principal und relevante validierte Felder kanonisieren und daraus einen Digest speichern. Ein späterer Request mit demselben Key im selben Geltungsbereich muss zu diesem Fingerprint passen.
Wie der Fingerprint gebildet wird, hängt von der Anwendung ab. Ein Hash der rohen JSON-Bytes ist einfach, doch bedeutungslose Leerzeichen oder eine andere Reihenfolge der Objekt-Member können gleichwertige Dokumente verschieden erscheinen lassen. Ein Hash ausgewählter validierter Werte vermeidet dieses Problem, aber die Auswahl muss alles enthalten, was die beabsichtigte Operation verändert. Der Vergleich darf außerdem erst erfolgen, nachdem die API den authentifizierten Geltungsbereich bestimmt hat. Andernfalls könnte der Key eines Benutzers mit dem Ergebnis eines anderen Benutzers kollidieren oder dieses offenlegen.
Der aktuelle IETF-Entwurf empfiehlt, die Wiederverwendung mit einem anderen Payload abzulehnen, und erörtert 422 Unprocessable Content. Für einen noch laufenden ursprünglichen Request schlägt er 409 Conflict vor. Das sind nützliche Empfehlungen eines Entwurfs, aber kein Ersatz für API-spezifische Dokumentation.
Festlegen, was ein abgeschlossener Retry zurückgibt
Eine Implementierung kann den ersten Status, ausgewählte Header und den Response Body speichern. Eine andere kann die ID der erzeugten Ressource speichern und eine semantisch gleichwertige Antwort neu aufbauen. Beide Ansätze haben Vor- und Nachteile.
Die exakte Antwortspeicherung liefert einen vorhersehbaren Replay, einschließlich eines früheren Fehlers, sofern dies die dokumentierte Richtlinie ist. Sie verbraucht jedoch Speicher und kann veraltete oder sensible Antwortdaten aufbewahren. Eine Rekonstruktion benötigt weniger Speicher, doch ihre Darstellung kann sich ändern, nachdem die Ressource geändert oder gelöscht wurde. Die richtige Zusage lautet daher nicht automatisch „dieselben Bytes“. Sie kann lauten: „Die Operation wird nicht erneut ausgeführt, und der Retry erhält ein Ergebnis, das mit der ursprünglichen Absicht vereinbar ist.“
Die Aufbewahrungsdauer bestimmt, wie lange selbst diese Zusage gilt. Nach dem Ablauf erkennt der Server den Key möglicherweise nicht mehr. Das Zeitfenster sollte plausible Retries und verspätete Requests abdecken und zugleich Speicher-, Datenschutz- und Domänenanforderungen berücksichtigen. Es sollte ausdrücklich festgelegt und nicht aus einem Anbieterbeispiel übernommen werden.
Idempotenz ist weder eine vollständige Retry-Richtlinie noch eine Sicherheitsgrenze
Der Client benötigt weiterhin vorsichtige Retry-Regeln. Er darf denselben Key nur für dieselbe beabsichtigte Operation wiederverwenden, sollte Zeitlimits anwenden, Hinweise des Servers wie gegebenenfalls Retry-After beachten und Backoff statt eines Retry-Sturms verwenden. Ein neuer Key bedeutet eine neue Operation.
Der Server sollte Syntax und Länge des Keys vor dem Speichern validieren, missbräuchliche Clients begrenzen und Lookups auf den authentifizierten Principal beschränken. Keys sollten opake Werte mit hoher Entropie sein und keine E-Mail-Adressen oder andere personenbezogene Daten. Ein Idempotency Key ersetzt weder Authentifizierung, Autorisierung, CSRF-Schutz und Eingabevalidierung noch eine Datenbanktransaktion.
Auch Observability ist wichtig. Logs können einen sicher behandelten Key-Hash, den Operationszustand, die Ressourcen-ID, die Anzahl der Versuche und den Konfliktgrund enthalten. Metriken für Payload-Abweichungen, parallele Duplikate, die Wiederverwendung abgelaufener Keys und lange Processing-Zustände können Client-Fehler und blockierte Operationen sichtbar machen, ohne jeden Retry als Fehler zu behandeln.
Wann ein anderes Design einfacher ist
Nicht jeder POST-Request benötigt einen Idempotenzspeicher. Eine natürlich eindeutige fachliche ID kann Duplikate bereits verhindern. Eine vom Client gewählte Ressourcen-URI mit PUT kann Ersetzungssemantik direkter ausdrücken. Eine schreibgeschützte Operation braucht diesen Mechanismus nicht. Bei einer wenig folgenreichen Aktion, deren Duplikate harmlos sind, können die Kosten für Zustand, Aufbewahrung und Bereinigung größer sein als der Nutzen.
Das Muster rechtfertigt seine Komplexität, wenn ein Ergebnis mehrdeutig werden kann und die Wiederholung des Nebeneffekts teuer ist: beim Anlegen einer Bestellung, Planen eines Jobs, Bereitstellen einer Ressource oder Starten einer externen Aktion. Auch dann sollte die Implementierung nur das versprechen, was sie innerhalb eines benannten Geltungsbereichs und Aufbewahrungsfensters durchsetzen kann.
Eine praktische Review-Checkliste
- Eine beabsichtigte Operation und den authentifizierten Geltungsbereich ihres Keys definieren.
- Ein begrenztes, opakes Key-Format validieren und geänderte Payloads ablehnen.
- Die Eindeutigkeit des Keys in der maßgeblichen Datenbank durchsetzen, nicht nur in PHP.
- Key-Anspruch und lokale fachliche Änderung möglichst in einer Transaktion halten.
- Parallele Duplikate, Abstürze und externe Nebeneffekte ausdrücklich berücksichtigen.
- Antwortverhalten nach Abschluss, wiederholbare Fehler, Aufbewahrung und Ablauf dokumentieren.
- Eine verlorene Antwort, zwei gleichzeitige Requests, einen geänderten Payload, einen Prozessabsturz und einen Retry nach Ablauf testen.
- Blockierte Processing-Zustände überwachen und Ergebnisse über Systemgrenzen hinweg abgleichen.
Fazit
Ein Idempotency Key bewirkt keine Exactly-once-Zustellung. Er gibt dem Client eine Möglichkeit, eine Absicht zu benennen, und dem Server eine Möglichkeit, einen weiteren Versuch zu erkennen. Die tatsächliche Sicherheit entsteht daraus, wie dieser Name begrenzt, beansprucht, verglichen, aufbewahrt und mit dem fachlichen Schreibvorgang verbunden wird.
Für eine kleine PHP-API ist ein zurückhaltender Ausgangspunkt am nützlichsten: ein klarer Vertrag, ein von der Datenbank erzwungener eindeutiger Key, ein Request-Fingerprint, eine ausdrückliche Zustandsmaschine und eine Transaktion für lokale Effekte. Sobald die Operation ein anderes System erreicht, sollte die verbleibende Unsicherheit sichtbar gemacht und behandelt werden, statt sie hinter einem beruhigend klingenden Header zu verbergen.