RAG für kleine KI-Anwendungen - Belege abrufen, ohne sie für Wahrheit zu halten
RAG für kleine KI-Anwendungen - Belege abrufen, ohne sie für Wahrheit zu halten
Wenn ein Language Model eine Frage zu einem privaten Dokument, einem Produkthandbuch oder einer sich ändernden internen Richtlinie beantwortet, entsteht eine unangenehme Lücke zwischen dem, was das Modell weiß, und dem, was die Anwendung wissen muss. Retrieval-augmented generation (RAG) ist eine Möglichkeit, diese Lücke zu verkleinern. Retrieval ist jedoch keine Wahrheitsmaschine. Es ist eine Methode, ausgewähltes Material vor das Modell zu legen, mit allen Risiken, die Auswahl und Interpretation mit sich bringen.
Diese Unterscheidung ist für eine kleine KI-Anwendung wichtig. Es ist verlockend, mit einer Vector Database zu beginnen und Antworten zu versprechen, die auf Unternehmensdokumenten beruhen. Ein besserer Ausgangspunkt sind einige Fragen: Welche Dokumente dürfen verwendet werden, wie werden relevante Abschnitte gefunden, was geschieht, wenn nichts Relevantes gefunden wird, und wie erkennt jemand, dass das System falsch liegt?
Was RAG zu einem Language Model hinzufügt
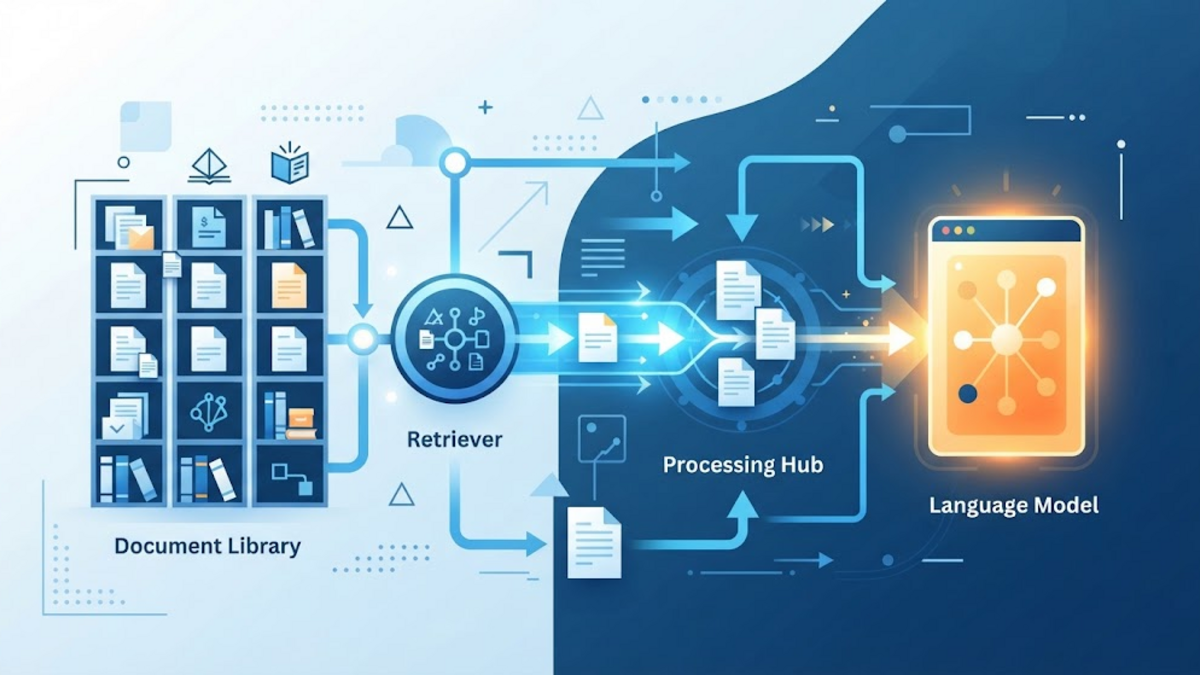
Ein Language Model enthält Wissen, das in seinen Parametern repräsentiert ist. RAG ergänzt eine externe Sammlung, die zur Anfragezeit durchsucht werden kann. Das RAG-Paper von Lewis und seinen Kollegen beschreibt ein Modell, das parametric memory mit non-parametric memory verbindet: Ein Retriever greift auf einen dense vector index zu, und der Generator verwendet das abgerufene Material bei der Erstellung der Antwort.
In einer kleinen Anwendung kann diese externe Sammlung aus Hilfeseiten, einem Datenbankexport oder sorgfältig ausgewählten Markdown-Dateien bestehen. Das Modell nimmt diese Dateien nicht automatisch als dauerhaftes Wissen auf. Die Anwendung ruft für eine bestimmte Frage einige Abschnitte ab und fügt sie dem Modelleingang hinzu.
Dadurch unterscheidet sich RAG von Fine-Tuning. Fine-Tuning verändert das Verhalten oder die Parameter eines Modells durch zusätzliches Training. RAG lässt die Modellparameter normalerweise unverändert und verändert den Context, der während der Inference geliefert wird. Beides kann kombiniert werden, löst aber unterschiedliche Probleme.
Die Pipeline ist mehr als eine Vector Search
Dokumentation stellt RAG oft als eine saubere Kette dar, doch jede Phase kann unabhängig ausfallen. Ein praktisches Denkmodell umfasst fünf Phasen.
1. Quellmaterial laden
Zuerst wird festgelegt, welche Dateien, Seiten, Datensätze oder API Responses zum Corpus gehören. Loading ist kein nebensächliches Detail. Wenn eine alte Richtlinie, ein Entwurf und die aktuelle Richtlinie ohne Metadaten in den Corpus gelangen, kann Retrieval die falsche Version finden und trotzdem plausibel wirken.
Auch Zugriffsregeln gehören hierher. Eine abgerufene Passage darf kein Dokument offenlegen, das der anfragende User nicht lesen darf. Erst nach der Generation zu filtern, ist zu spät: Das Modell hat den eingeschränkten Context bereits gesehen.
2. Material aufteilen und indizieren
Lange Dokumente werden normalerweise in Chunks aufgeteilt. Jeder Chunk kann als Embedding dargestellt werden, also als numerische Repräsentation, die bestimmte Aspekte seiner Bedeutung erfassen soll. Die Embeddings werden in einem Index gespeichert, damit eine Query nahegelegene Inhalte finden kann.
Eine überall richtige Chunk-Größe gibt es nicht. Ein zu kleiner Chunk kann die Bedingung verlieren, die einem Satz seine Bedeutung gibt. Ein zu großer Chunk kann mehrere nicht zusammengehörige Themen enthalten und mehr Context verbrauchen. Überschriften, Dokument-IDs, Daten, Access Labels und Links sind oft genauso wichtig wie der Text selbst.
Das Paper zu Dense Passage Retrieval beschreibt einen Dual-Encoder-Ansatz, der dichte Repräsentationen von Fragen und Passagen lernt. Das ist ein hilfreicher Hintergrund, um zu verstehen, warum Embeddings semantisch verbundene Passagen finden können. Die dort berichteten Benchmark-Ergebnisse sind jedoch keine Garantie für einen anderen Corpus, eine andere Sprache, ein anderes Modell oder eine andere Anwendung.
3. Index und Metadaten speichern
Der Index ist nur ein Teil des gespeicherten Zustands. Ein nützliches Ergebnis muss weiterhin auf ein Quelldokument und dessen Position verweisen. Speichere genügend Metadaten, um Authorization anzuwenden, nach Version oder Datum zu filtern und einen sinnvollen Beleg anzuzeigen. Ohne diese Verbindung kann ein System flüssigen Text erzeugen, aber die Prüfung des Materials, das die Antwort beeinflusst hat, erschweren.
4. Für eine Frage abrufen
Zur Query-Zeit wandelt die Anwendung die Frage in eine Suchanfrage um. Dense Retrieval kann ähnlich formulierte Inhalte finden, selbst wenn nur wenige Keywords übereinstimmen. Die OpenAI-Dokumentation zu Retrieval beschreibt beispielsweise semantische Suche in Vector Stores, Ergebnisgrenzen, Scores, Metadatenfilter und optionales Query Rewriting.
Keyword Search ist nicht überholt. Produktnamen, Fehlercodes, Versionsnummern und exakte IDs können durch semantische Ähnlichkeit allein schlecht gefunden werden. Eine hybride Strategie kann lexikalisches Matching mit Embeddings verbinden, und ein Reranker kann Kandidaten neu ordnen. Das sind Designentscheidungen, kein Beweis für die Richtigkeit eines Ergebnisses.
5. Antworten erzeugen und evaluieren
Die ausgewählten Passagen und die ursprüngliche Frage werden zum Context für das Language Model. Das Modell schreibt anschließend eine Antwort. Das ist die Generation-Phase, keine Datenbankabfrage, die eine verifizierte Tatsache zurückgibt. Das Modell kann eine Passage missverstehen, zwei widersprüchliche Passagen verbinden oder über das hinaus antworten, was der Context unterstützt.
LlamaIndex beschreibt Loading, Indexing, Storing, Querying und Evaluation als getrennte Phasen. Diese Trennung ist wertvoll, weil „die Antwort klingt gut“ keine Evaluationsmethode ist. Ein kleiner Testsatz sollte normale Fragen, Fragen ohne vorhandene Antwort, mehrdeutige Fragen, Fälle mit veralteten Dokumenten und Fälle zur Zugriffskontrolle enthalten.
Drei verschiedene Arten, wie RAG falsch liegen kann
Der Retriever findet die falsche Passage
Ein Suchergebnis kann thematisch passen, aber die Frage nicht beantworten. Ein Dokument kann beispielsweise beschreiben, wie ein Credential rotiert wird, während die Frage lautet, ob ein bestimmter User dazu berechtigt ist. Die Wörter hängen zusammen; die Authorization-Regel ist eine andere.
Der Corpus enthält die Antwort nicht
Retrieval kann keine Information finden, die nie geladen oder beim Preprocessing entfernt wurde. Eine verantwortungsvolle Anwendung braucht einen Abstention-Pfad: „Ich konnte in den bereitgestellten Dokumenten keine Belege finden“ ist ehrlicher, als die Lücke mit dem allgemeinen Modellwissen zu füllen.
Der Generator übertreibt den Beleg
Auch relevante Passagen können bedingt, widersprüchlich oder unvollständig sein. Das Modell nach Source-IDs zu fragen, kann die Nachvollziehbarkeit verbessern, aber ein Citation beweist nicht automatisch, dass der Satz aus dieser Quelle folgt. Citation-Anzeige und faktische Verifikation sind getrennte Aufgaben.
Ein kleines, vertretbares Design
Für eine kleine Anwendung darf die erste Version bewusst bescheiden sein. Halte einen versionierten Corpus vor, versehe jeden Chunk mit einer stabilen ID und einem Access Label, rufe nur eine begrenzte Zahl von Kandidaten ab und übergib ihre IDs zusammen mit dem Text. Weise das Modell an, nur aus dem bereitgestellten Context zu antworten und unzureichenden Context zu melden. Protokolliere dann Frage, abgerufene IDs, Modellantwort und die Einschätzung eines Reviewers mit angemessenen Datenschutzkontrollen.
Das ist allein noch keine Security Boundary. Nicht vertrauenswürdige Dokumente können Anweisungen enthalten, die sich an das Modell richten, sensible Daten können für den falschen User abgerufen werden, und Logs können zu einer zweiten Quelle für Datenlecks werden. Der frühere Artikel über Prompt Injection hat erklärt, warum Instructions keine Security Boundary sind; RAG fügt einen weiteren Eingabepfad hinzu, der mit derselben Vorsicht behandelt werden muss.
Evaluation sollte mindestens Retrieval-Relevanz und Antwortqualität getrennt messen. Wurde die erwartete Quelle abgerufen? Wird die Antwort durch den abgerufenen Text gestützt? Enthält sich das System, wenn Belege fehlen? Werden Berechtigungen eingehalten? Das AI Risk Management Framework von NIST ist breiter als RAG, aber sein Schwerpunkt auf dem Management und der Evaluation von KI-Risiken erinnert daran, dass eine einzelne Komponente kein ganzes System vertrauenswürdig macht.
Was RAG nicht verspricht
- RAG macht einen veralteten Corpus nicht aktuell.
- RAG garantiert nicht, dass das beste Ergebnis relevant ist.
- RAG macht aus einem nicht vertrauenswürdigen Dokument keine vertrauenswürdige Instruction.
- RAG beseitigt bei folgenreichen Entscheidungen nicht die Notwendigkeit von Access Control, Tests oder menschlicher Prüfung.
- RAG macht die Antwort eines Modells nicht gleichbedeutend mit einem Zitat aus seinen Quellen.
Fazit
RAG lässt sich am besten als Retrieval-and-Generation-Pipeline verstehen, nicht als Schalter, der ein Language Model in eine Datenbank verwandelt. Der Nutzen besteht darin, dem Modell im Moment einer Frage ausgewählten externen Context zu geben. Die schwierige Arbeit besteht darin, den Corpus zu definieren, das Richtige abzurufen, den Zugriff zu kontrollieren, fehlende Belege zu behandeln und Fehler zu messen.
Für eine kleine KI-Anwendung ist diese bescheidene Sichtweise eine Stärke. Bevor du Vector Databases vergleichst, mache die Beleggrenze explizit und baue Tests für die Fehler, die du entdecken möchtest. Die verbleibende Frage lautet nicht nur, ob das Modell antworten kann, sondern ob die Anwendung erklären kann, warum diese Antwort zugelassen wurde.
References
- Patrick Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv, revised April 12, 2021.
- Vladimir Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering, Association for Computational Linguistics, EMNLP 2020.
- OpenAI, Retrieval, official documentation, publication date not stated.
- LlamaIndex, Introduction to RAG, official documentation, publication date not stated.
- National Institute of Standards and Technology, AI Risk Management Framework, released January 26, 2023.