Rate Limiting für kleine Webanwendungen — Wiederholte Fehlschläge bremsen, ohne echte Nutzer auszusperren
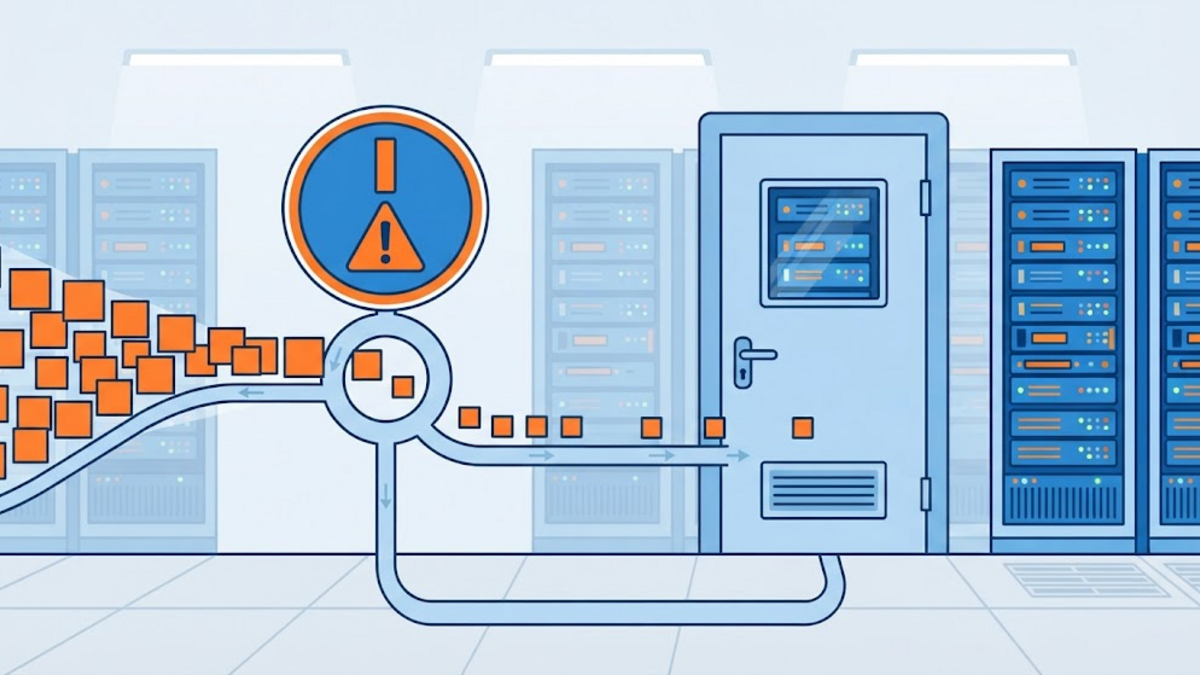
Irgendjemand wird versuchen, sich mit dem falschen Passwort tausende Male in deine Anwendung einzuloggen. Wenn dein Login-Formular im offenen Internet liegt, ist das keine hypothetische Überlegung, sondern das, was ein unbeaufsichtigter Endpunkt irgendwann anzieht. Die Frage ist nicht, ob du überhaupt zurückweisen solltest, sondern wie. Jede einfache Antwort zerstört etwas: Eine IP dauerhaft zu sperren bestraft eine geteilte Verbindung, ein Konto nach drei Versuchen zu sperren macht deinen Passwort-Reset zur Waffe, und es zu ignorieren lässt deine PHP-Worker eine Antwort auf ein Skript ausarbeiten, das sich niemals einloggen wird.
Das hier ist Rate Limiting für eine kleine Anwendung: der HTTP-Vertrag, den es bereits gibt, die Wahl dessen, was gezählt wird, die zwei Stellen, an denen du es durchsetzen kannst, und die Fehler, die einen Limiter schlimmer machen als gar keinen Limiter. Ich habe das mit dem Stack geschrieben, auf dem diese Seite tatsächlich läuft — Nginx vor PHP-FPM über einen Unix-Socket, dahinter MariaDB — und jeder Befehl und jedes Konfigurationsfragment unten wurde an dieser Maschine geprüft und nicht aus dem Gedächtnis erinnert. Wo ein Wert von deinem Traffic abhängt statt von einer Regel, sage ich das, statt eine Zahl zu erfinden.
Was HTTP dir schon verrät
Für diesen Fall gibt es einen Statuscode, und er ist alt genug, um langweilig zu sein. RFC 6585 definiert 429 Too Many Requests für den Fall, dass ein Client in einer bestimmten Zeit zu viele Requests gesendet hat. Die Antwort SHOULD Details enthalten, die die Lage erklären, und sie MAY einen Retry-After-Header enthalten, der sagt, wie lange zu warten ist. Der Code ist im IANA HTTP Status Code Registry mit RFC 6585 als Referenz eingetragen, also keine Erfindung eines Herstellers, die Clients nie gehört hätten.
Das Feld selbst ist in RFC 9110, Abschnitt 10.2.3 definiert: Sein Wert ist entweder ein HTTP-date oder eine Anzahl Sekunden, und dasselbe Feld wird zusammen mit 503 Service Unavailable verwendet, um anzugeben, wie lange ein Dienst voraussichtlich nicht verfügbar ist. Das ist der gesamte Vertrag — 429 plus Retry-After — und ein Client, der HTTP versteht, kann ihn befolgen, ohne etwas über deine Anwendung zu wissen.
Zwei Details in RFC 6585 verdienen einen zweiten Blick. Die Spezifikation sagt ausdrücklich, dass sie nicht definiert, wie der Origin-Server den Benutzer identifiziert und auch nicht, wie er Requests zählt: pro Ressource, pro Server oder über eine Gruppe von Servern hinweg, geschlüsselt nach Credentials oder nach einem zustandsbehafteten Cookie — alles bleibt offen. Alles Interessante hier passiert in genau dieser Lücke. Das zweite Detail ist unangenehmer: Antworten mit Status 429 dürfen nicht von einem Cache gespeichert werden, und die Sicherheitsbetrachtung des RFC merkt an, dass auch das Beantworten jedes Requests mit 429 während eines Angriffs Ressourcen verbraucht. Das RFC sagt nüchtern, dass Server nicht verpflichtet sind, 429 überhaupt zu verwenden, und dass das Verwerfen von Verbindungen angemessener sein kann. Ein Limiter, der mehr CPU verbraucht als der Angriff selbst, ist eine zweite Last und kein Limiter.
Erst den Schlüssel wählen, dann die Zahl
Bevor irgendeine Rate festgelegt werden kann, musst du entscheiden, was gezählt wird: die Adresse des Clients, das angegriffene Konto oder die vorgelegte Session.
Das Zählen nach IP ist am einfachsten einzusetzen und am einfachsten falsch zu machen. Es bestraft alle Menschen hinter einer gemeinsamen Adresse — ein Campusnetz, das NAT eines Mobilfunkbetreibers, ein Büro — für das Verhalten eines einzelnen Clients. Es versagt außerdem in genau der Richtung, auf die es am meisten ankommt: Das OWASP Credential Stuffing Prevention Cheat Sheet vermerkt, dass Credential-Stuffing-Toolkits üblicherweise Proxy-Netzwerke nutzen, um Requests auf viele Adressen zu verteilen — das umgeht sowohl IP-Sperrlisten als auch Rate Limiting, weil das Request-Volumen pro IP niedrig bleibt, selbst während eines Angriffs mit hohem Volumen.
Das Zählen nach Konto schließt diese Lücke. Das OWASP Authentication Cheat Sheet sagt es direkt: Der Zähler für fehlgeschlagene Logins sollte dem Konto selbst zugeordnet werden und nicht der Quell-IP-Adresse, damit ein Angreifer ihn nicht durch einen Wechsel der Adresse umgehen kann. Dasselbe Dokument warnt vor der offensichtlichen Gegenattacke: Bei einem Lockout muss darauf geachtet werden, dass er nicht als Denial of Service missbraucht wird, indem die Konten anderer Benutzer gesperrt werden. Ein Angreifer, der weiß, dass dein Endpunkt kontobasiert arbeitet, kann einen bekannten Kunden gezielt aussperren. OWASP listet auf, was ausbalanciert werden muss: die Anzahl fehlgeschlagener Versuche vor der Sperrung, das Beobachtungsfenster, die Dauer der Sperrung und ob diese Dauer mit jedem Fehlschlag exponentiell wächst.
Deshalb ist die sinnvolle Form zwei Limits und nicht eines: ein grobes Limit am Edge, geschlüsselt nach Adresse, schützt die Ressourcen deines Servers vor Massen-Traffic, während ein feineres Limit innerhalb der Anwendung, geschlüsselt nach Konto, ein einzelnes Konto davor schützt, geraten zu werden. Keiner der beiden Schlüssel reicht für sich allein, und die beiden leben an verschiedenen Orten mit unterschiedlichen Kosten, wenn sie auslösen.
Das Limit dorthin legen, wo ein Request am billigsten abzuweisen ist
Einen Request abzuweisen, bevor er PHP erreicht, ist wesentlich billiger, als ihn anzunehmen, eine Query auszuführen, ein Passwort zu hashen und am Ende trotzdem mit 429 zu antworten. Nginx kann das mit dem ngx_http_limit_req_module, der die Request-Verarbeitungsrate pro Schlüssel mit einem Leaky Bucket begrenzt und seinen Zustand in einer Shared-Memory-Zone hält.
http {
    limit_req_zone $binary_remote_addr zone=login:10m rate=5r/m;

    server {
        location = /login {
            limit_req zone=login burst=3 nodelay;
            limit_req_status 429;
            limit_req_log_level warn;
            limit_req_dry_run on;
        }
    }
}
Einige Details dort sind weniger offensichtlich, als sie aussehen. Der Standardstatus für einen abgewiesenen Request ist 503, nicht 429; limit_req_status 429 ist es also, die die Ablehnung des Moduls in etwas verwandelt, das ein Client als „bitte langsamer“ lesen kann und nicht als „die Seite ist kaputt“. Eine Rate unter einem Request pro Sekunde wird pro Minute angegeben, rate=5r/m bedeutet also fünf pro Minute; burst=3 lässt einen kurzen Peak durch, und nodelay nimmt diese Burst-Requests sofort an, statt sie zurückzuhalten. limit_req_dry_run on, das mit Nginx 1.17.1 hinzukam, zählt exakt wie sonst, weist aber nichts wirklich ab — der ehrliche Weg herauszufinden, ob ein Schwellenwert zu deinem Traffic passt, bevor er Leser abzuweisen beginnt. Das Modul stellt außerdem $limit_req_status mit Werten wie PASSED, DELAYED und REJECTED bereit.
Der Zustand selbst ist nicht unbegrenzt. Die Dokumentation nennt 128 Byte pro gespeichertem Zustand auf 64-Bit-Plattformen, eine Megabyte große Zone fasst also ungefähr achtausend Zustände; der am längsten nicht genutzte Zustand wird verworfen, wenn die Zone voll ist, und lässt sich überhaupt kein neuer Zustand anlegen, wird der Request mit einem Fehler beendet. Dieser letzte Fall ist wichtig: Eine volle Zone degradiert nicht sauber, sie lässt Requests scheitern.
Das Proxy-Problem, das jeden Besucher still verschmilzt
Hier ist der Fehler, den ich selbst gemacht hätte, wenn ich nicht nachgesehen hätte. $binary_remote_addr ist die Adresse des Peers, der die Verbindung geöffnet hat — richtig für einen direkt exponierten Server, falsch für alles, was hinter einem Proxy oder einem Tunnel steht. Diese Seite wird über einen Cloudflare-Tunnel erreicht, der TLS weiter oben beendet und über einfaches HTTP von localhost mit dem Origin spricht. Ich habe einen Request an die öffentliche URL mit einem eindeutigen Pfad gesendet und dann das Access-Log des Origins gelesen:
curl -s -o /dev/null -w '%{http_code}\n' "https://adammuiz.com/__rl_probe_1792602801617611643"
sudo grep __rl_probe /var/log/nginx/access.log
Das Log vermerkt diesen Request als von 127.0.0.1 kommend. Jeder Besucher aus dem Internet erreicht dieses Nginx unter derselben Adresse. Ein Limiter, der auf $binary_remote_addr geschlüsselt ist, würde die gesamte Leserschaft in einen Eimer legen, und die ersten wenigen Leser, die eintreffen, würden alle nachfolgenden aussperren — ein selbst zugefügter Denial of Service, der im Log exakt wie ein Angriff aussieht.
Die Lösung ist, Nginx zu sagen, welche Peers für den Client sprechen dürfen und welchem Header man glauben soll. Nginx erledigt das mit dem ngx_http_realip_module, der nicht standardmäßig aktiviert ist:
set_real_ip_from 127.0.0.1;
real_ip_header CF-Connecting-IP;
set_real_ip_from legt fest, welchen Peers man vertraut, eine Ersatzadresse zu liefern, und real_ip_header benennt das Header-Feld, das gelesen wird. Für Traffic, der von Cloudflare geproxxt wird, gibt die offizielle Dokumentation von Cloudflare genau diese Nginx-Konfiguration an und verweist auf die veröffentlichte Liste der Cloudflare-Adressen unter Cloudflare IP addresses für die Verwendung in set_real_ip_from, weil sich diese Liste ändert und aktualisiert werden muss. Die Referenz zu den Cloudflare-HTTP-Headern ergänzt, dass CF-Connecting-IP nur auf dem Hop vom Cloudflare-Edge zum Origin gesendet wird.
Dieselbe Falle existiert in PHP: Auch $_SERVER['REMOTE_ADDR'] ist die Peer-Adresse, ein Limiter auf Anwendungsebene muss also die wiederhergestellte Client-Adresse verwenden und nicht die Socket-Adresse. Das Prinzip ist das, das ich früher zu Client-IPs hinter einem Reverse Proxy beschrieben habe: Vertraue zuerst der Verbindung, bevor du dem Header vertraust, und vertraue dem Header nur, wenn die Verbindung selbst von jemandem kam, dem du bereits vertraust.
Innerhalb der Anwendung zählen
Der Limiter am Edge schützt den Server. Er kann dir nicht sagen, dass ein bestimmtes Konto zwölfmal gescheitert ist, weil er nicht weiß, welches Konto gerade versucht wird. Diese Prüfung gehört in die Anwendung, wo der Schlüssel das Konto sein kann und nicht die Adresse.
Zählen kennt eine kleine Familie von Modellen. Ein Fixed Window zählt Treffer innerhalb ausgerichteter Intervalle — die erste Minute des Fensters, die zweite Minute und so weiter. Es ist einfach und billig, mit einer vorhersehbaren Schwäche: Weil die Fenster ausgerichtet sind, kann ein Client das volle Kontingent am Ende eines Fensters und noch einmal am Anfang des nächsten senden. Ein Sliding Window zählt die Treffer der letzten N Sekunden, unabhängig davon, wo die Grenzen fallen, und entfernt damit den Peak an der Grenze um den Preis einer längeren Historie. Ein Token Bucket füllt ein Budget nach und nach auf und lässt einen Client es schneller ausgeben, wenn es Guthaben angesammelt hat — das nennt Nginx Leaky Bucket. Für einen Login-Endpunkt auf einem kleinen Server genügt ein Fixed Window meistens, solange man weiß, dass diese Grenze existiert.
Hier ist ein Fixed-Window-Zähler in PHP auf MariaDB, mit einem Upsert, damit Inkrement und Lesen auf derselben Zeile passieren:
<?php
final class FixedWindowLimiter
{
    public function __construct(private readonly PDO $pdo)
    {
    }

    public function hit(string $key, int $limit, int $windowSeconds): array
    {
        $start = (int) floor(time() / $windowSeconds) * $windowSeconds;
        $startSql = date('Y-m-d H:i:s', $start);

        $stmt = $this->pdo->prepare(
            'INSERT INTO rate_limit_counters (bucket_key, window_start, hits)
             VALUES (:key, :start, 1)
             ON DUPLICATE KEY UPDATE hits = hits + 1'
        );
        $stmt->execute(['key' => $key, 'start' => $startSql]);

        $stmt = $this->pdo->prepare(
            'SELECT hits FROM rate_limit_counters
             WHERE bucket_key = :key AND window_start = :start'
        );
        $stmt->execute(['key' => $key, 'start' => $startSql]);
        $hits = (int) $stmt->fetchColumn();

        return [
            'allowed'     => $hits <= $limit,
            'hits'        => $hits,
            'remaining'   => max(0, $limit - $hits),
            'retry_after' => max(0, ($start + $windowSeconds) - time()),
        ];
    }
}
Die Tabelle dahinter ist absichtlich langweilig:
CREATE TABLE rate_limit_counters (
  bucket_key   VARCHAR(191) NOT NULL,
  window_start DATETIME     NOT NULL,
  hits         INT UNSIGNED NOT NULL DEFAULT 0,
  PRIMARY KEY (bucket_key, window_start)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Ich habe dieses Muster gegen eine Scratch-Datenbank auf MariaDB 11.8.6 laufen lassen — nicht gegen die Produktionsdatenbank — mit einem Limit von fünf Versuchen pro sechzig Sekunden, und das Verhalten entsprach der Beschreibung: Die ersten fünf Versuche wurden erlaubt, wobei der verbleibende Zähler auf null sank, die Versuche sechs bis acht wurden abgelehnt, und ein anderer Schlüssel begann wieder bei eins. Das Upsert folgt dem dokumentierten Verhalten von INSERT ... ON DUPLICATE KEY UPDATE aus der MariaDB Knowledge Base.
Zwei Entscheidungen bleiben dir. Zähle nur Fehlschläge: Wenn auch eine erfolgreiche Anmeldung den Zähler erhöht, sperrt sich ein gemeinsam genutztes Büro oder eine Familie mit einem Konto bei normaler Nutzung selbst aus, und die Zahl, auf die es wirklich ankommt, ist die Anzahl falscher Versuche. Und lass den Limiter nicht zum Verstärker werden: Wenn jeder abgewiesene Request auch in die Datenbank schreibt, wird eine Flut von Ablehnungen deine Datenbank zum Teil, der umfällt. Das ist ein Argument dafür, die teure Prüfung am Edge zu lassen und den Zähler auf Anwendungsebene nur jene Requests bearbeiten zu lassen, die ihn ohnehin schon passiert haben.
Antworten so, dass Clients sich daran halten können
Wenn das Limit erreicht ist, muss die Antwort die zwei Dinge tragen, die ein Client braucht: den Status und die Wartezeit. Die MDN-Seite zu 429 beschreibt denselben Vertrag aus der Client-Sicht — Retry-After darf enthalten sein, um anzugeben, wie lange zu warten ist, und die Einschränkung kann serverweit oder pro Ressource gelten.
if (!$result['allowed']) {
    http_response_code(429);
    header('Retry-After: ' . $result['retry_after']);
    header('Content-Type: application/json; charset=utf-8');
    echo json_encode([
        'error'       => 'too_many_requests',
        'retry_after' => $result['retry_after'],
    ]);
    exit;
}
Zwei Dinge sollte diese Antwort nicht tun. Sie sollte nicht verraten, ob das Konto existiert, ein Limiter darf einer nicht registrierten Adresse also keine leisere Antwort geben. Und sie sollte einem legitimen Benutzer nicht sagen, dass jemand versucht, sein Passwort zu erraten, denn genau diese Information will ein Angreifer. OWASP formuliert einen verwandten Punkt beim Lockout: Einen Benutzer über fehlgeschlagene Versuche mit falschem Passwort zu informieren, ist meist unangemessen, während ein korrektes Passwort mit anschließend fehlgeschlagenem zweiten Faktor eine andere Situation ist.
Auf der Client-Seite ist das richtige Verhalten, Retry-After zu lesen und zu warten, nicht in einer engen Schleife erneut zu versuchen. Ein Client, der das ignoriert und sofort erneut versucht, wurde durch nichts gebremst außer durch deine Kapazität, die Wiederholungen aufzunehmen. Backoff mit Jitter ist die übliche Antwort, wenn keine explizite Wartezeit angegeben wird.
Ein Nuance zum Ökosystem: Einige Server kündigen ihren Quotenstand über RateLimit-*-Header an. Diese Namen sind bis heute in einem IETF Internet-Draft (draft-ietf-httpapi-ratelimit-headers) spezifiziert, den der Datatracker weiterhin als Active Internet-Draft ohne beabsichtigten RFC-Status führt, und eine Prüfung des IANA HTTP Field Name Registry am 22. Oktober 2026 ergab keinen registrierten Eintrag für sie. Retry-After ist der Teil, den jeder Client bereits versteht, also ist er der Teil, den es sich lohnt zu senden.
Was ein Limiter nicht leisten kann
Ein Limiter ist eine Schicht, und ausgerechnet diese Schicht ist die, die am höflichsten degradiert. OWASP ist klar: Adressen zu sperren kann unsophistizierte Angriffe stoppen, sollte aber nicht die einzige oder primäre Verteidigung sein, und eine Gegenmaßnahme sollte sich nicht auf eine einzelne vorhersehbare Volumengrenze stützen; sowohl kurze Burst-Zeiträume als auch längere Zeiträume verdienen Beachtung, weil ein Angreifer mit vielen Adressen jede einzelne individuell niedrig halten kann. Dieselbe Empfehlung rät zu einer abgestuften Reaktion, etwa einen zusätzlichen Faktor zu verlangen, wenn eine Anmeldung von einem neuen Gerät, einem ungewöhnlichen Ort oder einer einzelnen Adresse mit hohem Login-Volumen kommt.
Eine vollständige Antwort umfasst daher auch langsames Passwort-Hashing, Multi-Faktor-Authentifizierung und CAPTCHA als Verteidigung in der Tiefe statt als Eingangstür. Rate Limiting macht Raten zeitlich teuer. Es macht Raten nicht unmöglich, und es rettet kein System, das ein schwaches oder wiederverwendetes Passwort als akzeptabel behandelt.
Eine Checkliste, die zu einem kleinen Server passt
- Entscheide, was du schützt. Serverressourcen, ein einzelnes Konto und eine teure Operation sind unterschiedliche Ziele mit unterschiedlichen Schlüsseln.
- Beginne im Dry-Run-Modus.
limit_req_dry_runund$limit_req_statusvon Nginx zeigen, was ein Schwellenwert getan hätte, bevor er irgendetwas tut. - Stelle zuerst die Client-Adresse wieder her. Wenn ein Proxy oder Tunnel davorsteht, konfiguriere das Real-IP-Modul und schlüssel auf der wiederhergestellten Adresse. Ein Limiter auf der falschen Adresse ist schlimmer als kein Limiter.
- Verwende zwei Schlüssel, nicht einen. Ein grobes Limit am Edge für das Traffic-Volumen, ein feineres Limit in der Anwendung für das Konto.
- Zähle Fehlschläge, nicht Erfolge. Und halte den Zähler soweit wie möglich aus dem Request-Pfad heraus.
- Antworte mit 429 und Retry-After. Sorge dann dafür, dass dein eigenes Frontend diesen Status behandelt, statt eine kaputte Seite zu zeigen.
- Protokolliere Ablehnungen. Ein Limiter, den man nicht sieht, ist ein Limiter, den man nicht einstellen kann — Logs sind aber auch ein Schreibpfad, also halte sie aus der Datenbank heraus, die du schützt.
- Halte Maßnahmen befristet. Eine Sperre, die nie abläuft, ist eine Support-Warteschlange, und OWASPs Empfehlung ist ausdrücklich, dass Gegenmaßnahmen entfernbar sein müssen, wenn der Missbrauch nachlässt.
Was ich noch nicht sicher weiß
Ein paar Dinge bleiben für mich offene Fragen und keine festen Regeln. Es gibt keine universell richtige Anzahl von Versuchen pro Minute; die ehrliche Quelle für diese Zahl ist der Traffic, den du tatsächlich beobachtest, und das ist einer der Gründe, warum es den Dry-Run-Modus gibt. Ich bin mir nicht sicher, wie der Grenzfall eines Fixed Windows zu behandeln ist — ob ein verdoppeltes Limit am Fensterrand akzeptabel ist, hängt vom Endpunkt ab und davon, wie stark ein Benutzer dadurch belastet werden kann. Und die Wechselwirkung zwischen einem Limiter und den anderen Schichten ist die Stelle, an der ich am meisten zu lernen erwarte: Auslöser für eine MFA-Stufe, CAPTCHA-Schwellen und der Punkt, an dem ein blockierter Request einfach fallengelassen statt beantwortet werden sollte, wie RFC 6585 es erlaubt.
Worauf ich mich verlasse, ist schmaler, aber nützlicher: Das Protokoll hat bereits das richtige Vokabular dafür, und die häufigen Fehler sind keine Protokollfehler. Es sind: das Falsche zählen, es am falschen Ort zählen und es gegen eine Adresse zählen, die der Server nie tatsächlich gesehen hat.
Fazit
Rate Limiting auf einem kleinen Server ist im Wesentlichen eine Entscheidung über Identität und Platzierung. Entscheide, ob du eine Adresse oder ein Konto zählst, entscheide, ob die Ablehnung vor oder nach dem Einschalten von PHP passiert, und stelle sicher, dass die Adresse, die du zählst, die Adresse der Person ist und nicht die des Proxys davor. Nutze dann den Vertrag, den HTTP dir schon gegeben hat: 429, eine kurze Erklärung und Retry-After. Das ist ein Entwurf, den ein Mensch nachvollziehen und ein Client befolgen kann — eine höhere Messlatte, als die meisten defensiven Codes erreichen.
Referenzen
- RFC 6585 — Additional HTTP Status Codes (M. Nottingham, R. Fielding, IETF, April 2012)
- RFC 9110 — HTTP Semantics (R. Fielding, M. Nottingham, J. Reschke, IETF, June 2022), Abschnitt 10.2.3 zu
Retry-After - IANA — HTTP Status Code Registry
- IANA — HTTP Field Name Registry
- nginx — ngx_http_limit_req_module
- nginx — ngx_http_realip_module
- Cloudflare — Restoring original visitor IPs
- Cloudflare — Cloudflare HTTP headers
- Cloudflare — Cloudflare IP addresses
- OWASP — Authentication Cheat Sheet
- OWASP — Credential Stuffing Prevention Cheat Sheet
- MDN — 429 Too Many Requests
- MariaDB Knowledge Base — INSERT ... ON DUPLICATE KEY UPDATE
- IETF Datatracker — draft-ietf-httpapi-ratelimit-headers