Regression Evals für kleine LLM-Workflows - Die Änderung testen, nicht die Demo
Ein Prompt wird überarbeitet, ein neueres Modell ausgewählt oder eine Retrieval-Einstellung angepasst. Die ersten Ausgaben sehen sauberer aus als zuvor. Ist der Workflow tatsächlich besser geworden, oder hat die Vorführung lediglich die Fälle vermieden, die sich verschlechtert haben?
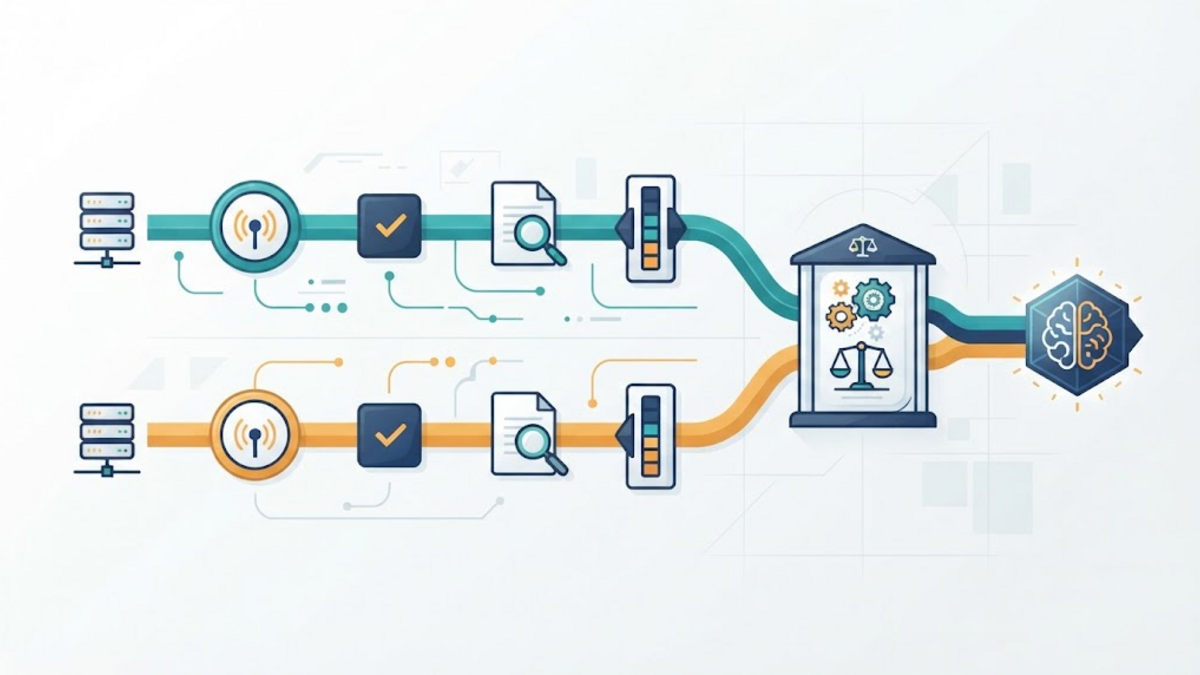
Genau darin liegt die praktische Aufgabe einer Regression Eval: Eine vorgeschlagene Änderung und die aktuelle Baseline werden anhand derselben festgelegten Anforderungen ausgeführt. Anschließend wird geprüft, welches Verhalten sich verbessert hat, weiterhin akzeptabel ist oder eine Regression zeigt. Das ähnelt eher einer wiederholbaren Release-Prüfung als einem öffentlichen Modell-Leaderboard. Auch das Versprechen bleibt bewusst begrenzt. Eine Eval kann Fehler aufdecken, die durch ihre Fälle und Grader repräsentiert werden; sie kann nicht beweisen, dass eine LLM-Anwendung in jeder Situation korrekt oder sicher ist.
Den Workflow evaluieren, nicht den Ruf des Modells
Ein Modell-Benchmark fragt, wie Systeme bei einer standardisierten Aufgabensammlung abschneiden. Eine Anwendungs-Eval fragt, ob ein bestimmter Workflow seine Aufgabe unter den Bedingungen erfüllt, die für seine Nutzer relevant sind. Diese Fragen überschneiden sich, sind aber nicht austauschbar.
Ein Publishing-Assistent muss beispielsweise Quell-URLs bewahren, bei fehlenden Belegen auf eine Antwort verzichten, Vorbehalte in Übersetzungen erhalten und darf keine Veröffentlichung vorschlagen, wenn eine erforderliche Datei fehlt. Ein allgemeiner Modellwert prüft diese Grenzen nicht direkt. Die zu testende Einheit umfasst Developer Instructions, Modell und Parameter, abgerufenen Kontext, Tools, Anwendungscode und Output-Prüfungen, die gemeinsam das sichtbare Ergebnis erzeugen.
Die Evaluationshinweise von OpenAI empfehlen aufgabenspezifische Evaluationen und unterscheiden Unsicherheiten bei einzelnen Modellaufrufen, Workflows und Agents. Diese Trennung ist auch ohne die Tools von OpenAI nützlich. Wenn ein Workflow eine Artikel-ID extrahiert, einen Datensatz abruft und eine Antwort entwirft, sollten Extraktion, Retrieval und endgültige Antwort nach Möglichkeit getrennt getestet werden. Ein End-to-End-Fehler lässt sich dann leichter lokalisieren als mit dem pauschalen Urteil, „die KI ist gescheitert“.
Erwartungen in beobachtbare Kriterien übersetzen
„Die Antwort soll gut sein“ ist noch kein Test. Vor dem Sammeln von Fällen sollte festgehalten werden, was Erfolg und ein nicht akzeptabler Fehler für diese Anwendung bedeuten. Die Evaluationsdokumentation von Anthropic beschreibt nützliche Kriterien als spezifisch, messbar, erreichbar und relevant. Sie weist zugleich darauf hin, dass die meisten Anwendungen mehrere Dimensionen benötigen.
Für einen kleinen Recherche- und Schreibworkflow könnte die Scorecard folgende Fragen stellen:
- Werden Tatsachenbehauptungen durch die bereitgestellten Quellen gestützt?
- Erklärt die Ausgabe, dass die Belege nicht ausreichen, wenn der Corpus keine Antwort enthält?
- Bleiben Zitate, URLs, Daten und Code exakt erhalten, wenn dies erforderlich ist?
- Bewahrt eine Übersetzung jeden Absatz und jeden Vorbehalt, ohne eine neue Behauptung hinzuzufügen?
- Wählt der Router ausschließlich ein erlaubtes Tool und übergibt den richtigen stabilen Identifier?
- Bleibt der Workflow innerhalb seines Latenz- und Kostenbudgets?
Diese Kriterien sollten nicht vorschnell zu einem einzigen Durchschnitt zusammengefasst werden. Das HELM-Forschungsprojekt plädiert für Evaluation über verschiedene Szenarien und mehrere Metriken hinweg, statt zuzulassen, dass Accuracy Robustness, Fairness, Toxicity, Efficiency oder andere Tradeoffs verdeckt. Eine kleine Anwendung muss den Umfang von HELM nicht nachbilden, profitiert aber von derselben Frage: Welche wichtige Dimension könnte sich verbessern, während eine andere unbemerkt schlechter wird?
Einen kleinen Datensatz aufbauen, der ehrlicher werden kann
Der erste Datensatz muss nicht riesig sein. Er muss verständlich, versioniert und mit der Aufgabe verbunden sein. Jeder Fall kann einen Input, den relevanten Kontext, das erwartete Verhalten, Bewertungsregeln und eine kurze Begründung für seine Aufnahme enthalten.
Ein ausgewogener erster Satz sollte mehr als erfolgreiche Beispiele enthalten:
- Gewöhnliche Fälle: repräsentative Anfragen, die der Workflow verarbeiten soll.
- Grenzfälle: lange Eingaben, fehlende Felder, mehrdeutige Anfragen, ungewöhnliche Formatierung und unterstützte Sprachen.
- Negative Fälle: Anfragen, die das System ablehnen, zurückstellen oder mit „unzureichende Belege“ beantworten sollte.
- Bekannte Fehler: geprüfte Vorfälle, die zuvor zu falschem Routing, unbelegten Behauptungen, verlorenen Vorbehalten oder malformed Output geführt haben.
- Kontrollfälle: einfache Beispiele, die stabil bleiben und ein defektes Test Harness schnell sichtbar machen sollten.
Ein Datensatz, der nur aus erdachten Beispielen besteht, kann die Formen übersehen, die in der realen Nutzung auftreten. Logs und Nutzerfeedback können bessere Fälle liefern, aber auch personenbezogene Daten, Secrets, urheberrechtlich geschütztes Material oder feindliche Eingaben enthalten. Datensätze sollten minimiert und redigiert, Zugriffe kontrolliert und der Aufbewahrungsgrund jedes Falls dokumentiert werden; außerdem ist jede im jeweiligen Kontext erforderliche Einwilligung einzuholen. „Alles protokollieren“ ist keine Erlaubnis für ein unbeschränktes Prompt-Archiv.
Einige geprüfte Fälle sollten vom alltäglichen Prompt-Tuning getrennt bleiben. Wenn jeder Fehler beim Bearbeiten des Prompts ständig sichtbar ist, kann der Workflow die Formulierung des Tests lernen, ohne bei ähnlichen Eingaben zuverlässiger zu werden. Ein Held-out Set verhindert Kontamination nicht vollständig, ermöglicht aber einen aussagekräftigeren abschließenden Vergleich.
Den Grader an die Behauptung anpassen
Nicht jeder Output benötigt ein weiteres Modell als Bewerter. Es sollte der am wenigsten mehrdeutige Grader eingesetzt werden, der die jeweilige Anforderung prüfen kann.
Deterministische Prüfungen
Gewöhnlicher Code eignet sich für exakte Eigenschaften: valides JSON, erforderliche Keys, erlaubte Enum-Werte, erhaltene URLs, Absatzanzahl, verbotene Tool-Namen oder die Gleichheit einer erwarteten und tatsächlichen Datensatz-ID. Diese Prüfungen lassen sich schnell wiederholen und leicht erklären. Auch sie können eine falsche Anforderung kodieren, führen jedoch nicht die Interpretation eines zweiten Modells ein.
Menschliche Rubrics
Menschen werden benötigt, wenn Relevanz, Klarheit, Übersetzungsqualität, Beleglage oder Schweregrad nicht ehrlich auf einen String-Vergleich reduziert werden können. Eine Rubric sollte jedes Kriterium definieren und Beispiele nahe der Entscheidungsgrenze zeigen. Reviewer können unterschiedlicher Meinung sein. Diese Abweichung ist selbst eine Information: Sie kann auf eine unklare Rubric, einen mehrdeutigen Fall oder eine Anforderung hinweisen, über die das Team noch keine Einigkeit erzielt hat.
Modell-Grader
Ein Modell-Grader kann wiederholte Prüfungen offener Ausgaben erschwinglicher machen, besonders für paarweise Vergleiche oder eine enge Pass/Fail-Rubric. Er bleibt dennoch ein Messinstrument und ist keine Ground Truth. Das Paper zu MT-Bench und Chatbot Arena untersucht LLM Judges und identifiziert Position Bias, Verbosity Bias, Self-Enhancement Bias sowie begrenzte Reasoning-Fähigkeiten. Die dort berichteten Übereinstimmungen gelten für die Modelle, Prompts und Daten der Studie; sie sind keine Garantie für einen anderen Judge, eine andere Sprache oder Domain.
Bevor ein Modell-Grader zum Release Gate wird, sollten seine Entscheidungen mit einem Datensatz verglichen werden, der von den für die Anwendung verantwortlichen Menschen gelabelt wurde. Abweichungen sind zu untersuchen, die Rubric ist zu präzisieren, bei paarweisen Bewertungen sollte eine vertauschte Antwortreihenfolge getestet werden, und bei Änderungen am Judge-Modell oder -Prompt ist die Kalibrierung erneut zu prüfen. Wenn Grader und Kandidat dieselben Blind Spots teilen, kann ein präzise wirkender Wert sie verstärken, statt sie aufzudecken.
Den Kandidaten mit einer festen Baseline vergleichen
Ein Regression Run sollte genügend Konfiguration festhalten, um den Vergleich zu erklären: Datensatzversion, Prompt-Version, Modell-Identifier, Retrieval-Einstellungen, Tool-Definitionen, Grader-Versionen und die relevante Anwendungsrevision. Baseline und Kandidat müssen mit denselben Fällen und Gradern ausgeführt werden. Andernfalls könnte ein veränderter Wert einen veränderten Test statt eines veränderten Workflows beschreiben. Dies entspricht dem in OpenAIs Dokumentation zu Working with Evals beschriebenen Zyklus aus Aufgabe, Test-Inputs, Kriterien und Ergebnisanalyse, ohne von der aktuellen Produktoberfläche abzuhängen.
Ergebnisse sollten auf Fallebene und nicht nur als Gesamtwert erfasst werden. Ein Kandidat, der einen zusätzlichen Style-Fall besteht, aber in einem negativen Fall eine Quelle zu erfinden beginnt, darf sich nicht hinter einem geringfügig besseren Durchschnitt verstecken. Nützliche Review-Ansichten umfassen:
- Fälle, die von Pass zu Fail wechseln;
- Fälle, die von Fail zu Pass wechseln;
- Fehler mit hohem Schweregrad unabhängig vom aggregierten Wert;
- Abweichungen zwischen Gradern und unsichere menschliche Labels;
- Änderungen bei Kosten, Latenz, Refusal und Tool-Nutzung.
Generierte Ausgaben können variieren, selbst wenn der sichtbare Input unverändert bleibt. Wiederholte Runs können deshalb bei instabilen oder folgenreichen Fällen angemessen sein. Es gibt jedoch weder eine universelle Wiederholungszahl noch einen universellen Pass-Grenzwert. Die Entscheidung hängt von den Folgen eines Fehlers, der erwarteten Variabilität, dem Budget und der Konfiguration des Workflows ab. Diese Richtlinie sollte ausdrücklich festgelegt werden, statt eine Zahl aus einem unpassenden Benchmark zu übernehmen.
Das Release Gate eng und explizit gestalten
Eine Release-Richtlinie kann mehrere Regeln kombinieren: keine Regression bei kritischen deterministischen Prüfungen, kein neuer von Menschen geprüfter Fehler mit hohem Schweregrad, akzeptable Leistung bei gewöhnlichen Fällen und begrenzte Betriebskosten. Ein fehlgeschlagenes Gate sollte den Rollout stoppen oder eine dokumentierte Entscheidung erfordern. Es sollte nicht automatisch Änderungen auslösen, bis der Wert zufällig steigt.
Dieses Gate ergänzt andere Kontrollen. Schema Validation prüft weiterhin die Form. Authorization beschränkt weiterhin, wer handeln darf. Vor einem folgenreichen Side Effect kann weiterhin Human Approval erforderlich sein. Nach dem Release bleibt Monitoring notwendig. Das NIST Generative AI Profile ordnet Evaluation in ein umfassenderes Risk Management über den gesamten Lifecycle ein; es behandelt einen einzelnen Pre-Release-Wert nicht als Ersatz für Design, Oversight, Incident Response oder fortlaufende Messung.
Wenn ein geprüfter Produktionsfehler auftritt, sollte eine minimierte Version in das Regression Set aufgenommen, das erwartete Verhalten beschrieben und der Fall auch nach dem unmittelbaren Fix beibehalten werden. Die Suite wird dadurch zu einer Aufzeichnung der Anforderungen und entdeckten Failure Modes statt zu einem Showcase, der nur einmal vor dem Start zusammengestellt wurde.
Was eine bestandene Eval nicht beweist
Eine bestandene Suite bedeutet, dass die getestete Konfiguration die kodierten Kriterien bei den geprüften Fällen nach Maßgabe der ausgewählten Grader erfüllt hat. Sie zeigt nicht, dass die Fälle jeden künftigen Nutzer repräsentieren, die Referenzen vollständig sind, ein Modell-Judge frei von Bias ist oder eine bisher ungesehene Tool-Abfolge sicher ist. Sie kann einen Fehler auch deshalb übersehen, weil die Rubric nie die relevante Frage gestellt hat.
Diese Begrenzung ist kein Grund, wieder bloßer Intuition zu folgen. Sie ist ein Grund, die Behauptung im Verhältnis zu den Belegen zu halten. Eine Regression Eval ersetzt „diese Demo sah besser aus“ durch einen nachvollziehbaren Vergleich. Sie kann einem kleinen Team zeigen, welche bekannten Verhaltensweisen eine Änderung überstanden haben, wo Tradeoffs aufgetreten sind und was weiterhin menschliches Urteil benötigt.
Fazit
Die nützliche Eval ist nicht der größte Benchmark oder das aufwendigste Dashboard. Sie ist der kleinste wiederholbare Test, der die tatsächlichen Verpflichtungen des Workflows widerspiegelt und wichtige Fehler vor dem Release sichtbar macht. Diese Verpflichtungen sind zu definieren, repräsentative und schwierige Fälle zu sammeln, deterministische Prüfungen nach Möglichkeit einzusetzen, urteilsgestützte Grader zu kalibrieren und jeder Kandidat mit derselben Baseline zu vergleichen.
Das Ergebnis ist keine Gewissheit. Es ist eine bessere Frage im Moment der Änderung: nicht „Kann die neue Version eine beeindruckende Antwort erzeugen?“, sondern „Welche erforderlichen Verhaltensweisen hat sie bewahrt, welche verbessert, und welche Belege sprechen dafür, dass sie das bereits Funktionierende ersetzen kann?“
References
- OpenAI. Evaluation best practices. Live-Dokumentation, abgerufen am 1. November 2026.
- OpenAI. Working with evals. Live-Dokumentation, abgerufen am 1. November 2026.
- Anthropic. Define success criteria and build evaluations. Live-Dokumentation, abgerufen am 1. November 2026.
- Chloe Autio et al. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1, 26. Juli 2024; Seite aktualisiert am 8. April 2026.
- Percy Liang et al. “Holistic Evaluation of Language Models.” Transactions on Machine Learning Research, 2023.
- Lianmin Zheng et al. “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena.” NeurIPS 2023 Datasets and Benchmarks Track, überarbeitet am 24. Dezember 2023.