systemd-OnFailure-Hooks für einen Heimserver - Fehler weiterleiten, ohne sie Monitoring zu nennen
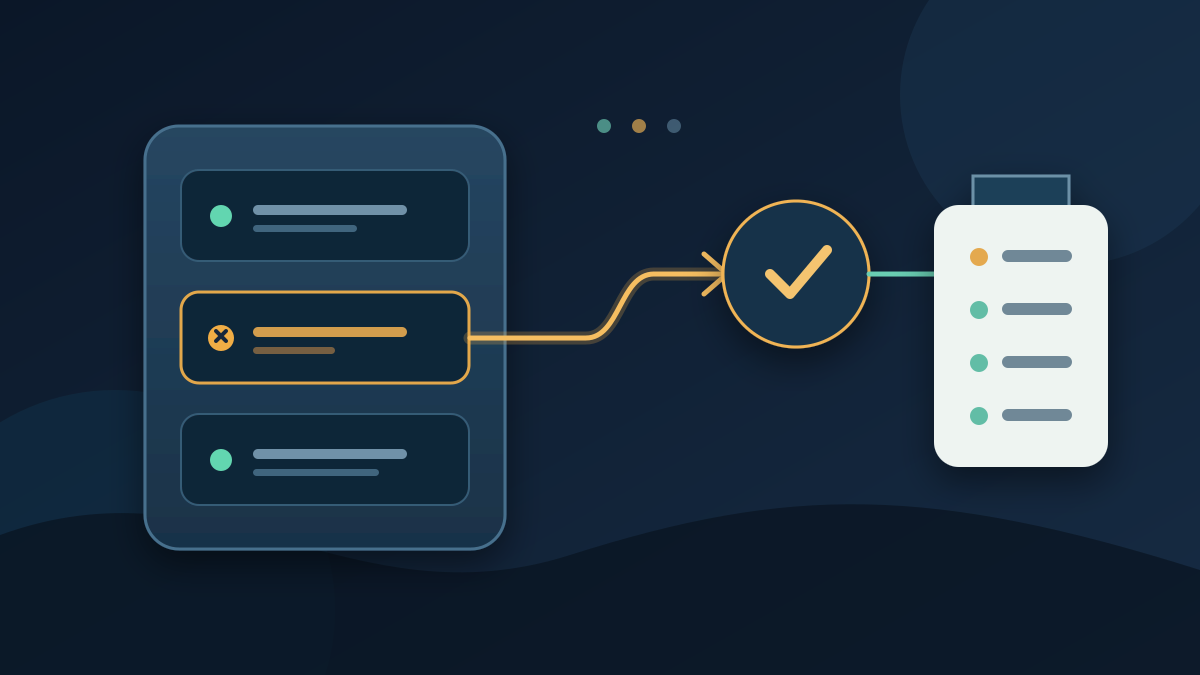
Ein Dienst schlägt um 02:00 Uhr fehl, hinterlässt eine hilfreiche Erklärung im Journal und bleibt unbemerkt, bis ihn am nächsten Morgen jemand benötigt. Eine Restart-Policy kann den Prozess möglicherweise wiederherstellen, doch Wiederherstellung und Sichtbarkeit sind zwei verschiedene Fragen. Wie kann ein kleiner Heimserver einen klaren Pfad von „Diese Unit ist fehlgeschlagen“ zu „Dieses Ereignis aufzeichnen oder melden“ schaffen, ohne diesen Pfad als vollständiges Monitoring-System auszugeben?
systemd stellt dafür einen kompakten Baustein bereit: OnFailure=. Die Direktive versendet nicht selbstständig eine E-Mail und ruft auch nicht von sich aus einen Webhook auf. Laut der offiziellen systemd.unit-Dokumentation aktiviert sie eine oder mehrere benannte Units, wenn die Quell-Unit den Zustand failed erreicht. Gerade diese präzise Grenze macht die Funktion nützlich und verhindert zugleich, dass sie eine universelle Alerting-Lösung ist.
Bei der Zustandsänderung beginnen, nicht beim Benachrichtigungskanal
Eine systemd-Unit kann active, inactive oder failed sein oder sich in einem Übergangszustand befinden. Das systemctl-Handbuch beschreibt failed als einen Zustand, der inactive ähnelt, bei dem die Unit jedoch auf irgendeine Weise fehlgeschlagen ist, etwa durch einen fehlerhaften Exit, einen Absturz, ein Timeout oder zu viele Restart-Versuche. Die genauen Ursachen hängen weiterhin vom Unit-Typ und seiner Konfiguration ab.
OnFailure= reagiert auf diesen Zustand. Ein reguläres systemctl stop versetzt einen Dienst normalerweise in inactive und nicht in failed, daher ist es kein Alert-Test. Auch eine Unit, die wegen einer nicht erfüllten Condition...=-Prüfung übersprungen wurde, ist nicht zwangsläufig fehlgeschlagen. Diese Unterscheidung ist wichtig: Ein Alert für jede inaktive Unit würde normale Shutdowns und absichtlich ruhende Dienste in Rauschen verwandeln.
Es hilft, drei Aufgaben zu trennen:
- Detection: systemd entscheidet, dass die Quell-Unit den Zustand
failederreicht hat. - Routing:
OnFailure=weist systemd an, eine Handler-Unit zu aktivieren. - Delivery: Der Handler zeichnet das Ereignis lokal auf oder übergibt es an einen externen Kanal.
Nur die ersten beiden Aufgaben werden von OnFailure= bereitgestellt. Ein Mailserver, eine Chat-API oder ein Webhook kann weiterhin unerreichbar sein. Die getrennten Schichten machen Fehler leichter nachvollziehbar.
Einen wiederverwendbaren Handler per Drop-in anbinden
Angenommen, ein Dienst heißt example-app.service. Statt eine von einem Paket gelieferte Unit-Datei zu bearbeiten, wird unter /etc/systemd/system/example-app.service.d/failure-hook.conf ein Drop-in hinzugefügt:
[Unit]
OnFailure=unit-failure@%n.service
Der Specifier %n wird zum vollständigen Namen der Quell-Unit erweitert. In diesem Beispiel aktiviert systemd eine Instanz entsprechend [email protected]. Das doppelte .service wirkt ungewöhnlich, doch das erste Vorkommen gehört zum Instanzwert und das letzte ist das Suffix der Handler-Unit selbst.
Nun wird das Template /etc/systemd/system/[email protected] erstellt:
[Unit]
Description=Record failure of %i

[Service]
Type=oneshot
ExecStart=/usr/bin/logger --tag=unit-failure Failure hook activated for %i
Innerhalb des Templates wird %i zum Instanznamen erweitert, in diesem Fall also zu example-app.service. Das Beispiel verwendet bewusst logger statt eines echten Remote-Notifiers. Es weist nach, dass der Routing-Pfad ausgeführt wird und eine lokale Spur hinterlässt. Es legt keine Zugangsdaten offen, hängt nicht von einem bestimmten Anbieter ab und behauptet nicht, dass eine entfernte Nachricht zugestellt wurde.
Ein produktiver Handler kann diesen Befehl durch einen kleinen, eng begrenzten Notifier ersetzen. Seine Schnittstelle sollte einen Unit-Namen annehmen, eine kurze Nachricht ableiten, ein Timeout anwenden und einen aussagekräftigen Exit-Status zurückgeben. Secrets gehören weder in ein öffentliches Unit-Beispiel noch direkt in eine Kommandozeile. Der Handler sollte außerdem nicht allein deshalb als root laufen, weil der Quelldienst dies tut; er sollte nur die Identität sowie den Datei- und Netzwerkzugriff erhalten, die seine Delivery-Methode benötigt.
Die Syntax prüfen, bevor PID 1 sie verwenden soll
Reload und Test sollten bewusst erfolgen. Laut der offiziellen systemd-analyze verify-Dokumentation kann der Befehl unbekannte Direktiven, fehlende erforderliche Dependencies, nicht verfügbare Befehle und verschiedene andere strukturelle Fehler melden.
sudo systemd-analyze verify \
  example-app.service \
  /etc/systemd/system/[email protected]
sudo systemctl daemon-reload
systemctl cat example-app.service
Stammt die Quell-Unit aus einem Paket, lässt sich die effektive Unit samt Drop-ins mit systemctl cat prüfen. Ein sauberes Verifikationsergebnis ist nützlich, aber begrenzt: Es kann nicht beweisen, dass DNS funktioniert, ein API-Token gültig ist, ein Empfänger existiert oder ein entfernter Dienst die Nachricht angenommen hat. Syntaxprüfung und Delivery-Test sind zwei getrennte Gates.
Mit einem entbehrlichen Fehler testen
Einen echten Webserver für einen Alert-Test absichtlich zu beschädigen, ist ein unnötiges Risiko. Eine temporäre Test-Unit kann die Zustandsänderung auslösen, ohne eine Anwendung anzutasten. Die folgende Konfiguration wird als /etc/systemd/system/failure-hook-test.service gespeichert und erhält denselben Hook:
[Unit]
Description=Disposable failure-hook test
OnFailure=unit-failure@%n.service

[Service]
Type=oneshot
ExecStart=/usr/bin/false
Nach einem weiteren daemon-reload wird der Test gestartet und beide Seiten werden geprüft:
sudo systemctl start failure-hook-test.service
systemctl status failure-hook-test.service --no-pager
systemctl status [email protected] --no-pager
journalctl -u failure-hook-test.service --no-pager
journalctl -u [email protected] --no-pager
journalctl -t unit-failure --no-pager
Der erste Befehl soll fehlschlagen, weil /usr/bin/false erfolglos endet. Dieses Ergebnis ungleich null ist Teil des Tests und kein Beleg dafür, dass der Hook übersprungen wurde. Status und Journal der Quelle sollten den Quellfehler erklären; Status und markierter Journal-Eintrag des Handlers sollten zeigen, ob die sekundäre Unit ausgeführt wurde. Die journalctl -u-Dokumentation weist darauf hin, dass dieser Filter Meldungen einschließt, die von und über die ausgewählte Unit ausgegeben wurden.
Nach dem Festhalten des Ergebnisses wird die entbehrliche Unit entfernt, der Manager neu geladen und der gespeicherte Fehlerzustand bereinigt:
sudo systemctl reset-failed failure-hook-test.service
sudo rm /etc/systemd/system/failure-hook-test.service
sudo systemctl daemon-reload
reset-failed löscht den Failed-Zustand und setzt außerdem die unitbezogenen Start-Limit- und Restart-Zähler zurück. Das ist Bereinigung, keine Diagnose; das Journal sollte gelesen werden, bevor nützlicher Runtime-Zustand gelöscht wird.
Restart-Policy und Failure-Routing sind verschiedene Kontrollen
Restart=on-failure beantwortet die Frage, ob systemd versuchen soll, einen Dienst erneut auszuführen. OnFailure= beantwortet die Frage, ob beim Erreichen von failed eine weitere Unit aktiviert werden soll. Ein Dienst kann sich nach einem Restart erholen und dennoch einen Eintrag verdienen, während ein dauerhaft fehlschlagender Dienst schließlich sein Start-Limit erreichen kann. Die systemd.service-Dokumentation beschreibt sowohl Restart-Ursachen als auch Rate-Limiting; keine der Einstellungen sollte eine ungelöste Fehlerschleife verbergen.
Hinzu kommt eine versionsabhängige Ausnahme. RestartMode=direct, das mit systemd 254 hinzugefügt wurde, überspringt bei automatischen Restarts den Übergang über failed/inactive und damit auch OnFailure= für diese Versuche. Die Dokumentation zu systemd 252 aus Debian bookworm enthält diesen neueren Modus nicht, die aktuelle Upstream-Dokumentation dagegen schon. Deshalb sollten systemctl --version und die effektive Dienstkonfiguration geprüft werden, statt für jeden Host das neueste Handbuch vorauszusetzen.
Einplanen, dass auch der Handler ausfallen kann
Ein Handler läuft auf derselben Maschine wie das Problem, das er meldet. Ist der Datenträger voll, die Namensauflösung defekt, das Netzwerk ausgefallen oder der Host ohne Strom, kann er möglicherweise nichts zustellen. Ein lokaler Journal-Eintrag bleibt für eine spätere Diagnose wertvoll, kann aber niemanden über eine vollständig unerreichbare Maschine informieren. Externe Uptime-Checks beobachten aus einer anderen Failure-Domain und bleiben erforderlich, wenn bereits die Abwesenheit des Hosts erkannt werden muss.
Wiederholte Abstürze erzeugen ein anderes Problem: zu viele Meldungen. systemd-Start-Limits können die Restart-Versuche eines Dienstes begrenzen, doch ein Notifier benötigt möglicherweise weiterhin eine eigene Deduplication- oder Cooldown-Policy. Ein nützliches Ereignis sollte Host, Unit, Zeitpunkt und ein kleines stabiles Ergebnisfeld nennen. Es sollte auf Logs verweisen, statt ein unbegrenztes Journal in jede Nachricht zu kopieren. Environment-Variablen oder Kommandozeilen sollten nicht blind übernommen werden, weil sie Zugangsdaten enthalten können.
Auch die Handler-Unit selbst muss beobachtbar sein. Sie sollte mit systemctl --failed geprüft, ihr Journal gelesen und der tatsächliche Delivery-Kanal regelmäßig getestet werden. Ein grüner Quelldienst beweist nicht, dass die Zugangsdaten des Notifiers vom vergangenen Monat noch funktionieren. Umgekehrt sollte ein fehlgeschlagener Notifier die zu meldende Anwendung weder neu starten noch stoppen; der Meldepfad sollte ein Side-Channel bleiben und keine neue harte Dependency werden.
Den Hook für ein enges Versprechen einsetzen
OnFailure= ist ein kleiner Mechanismus mit einem nützlichen Vertrag: Wenn systemd einen echten Übergang in den Zustand failed festhält, kann es eine weitere Unit aktivieren. Ein Drop-in pro Dienst, ein wiederverwendbares Template, eine lokale Journal-Spur und ein entbehrlicher Test reichen aus, um diesen Vertrag sichtbar zu machen.
Das ehrliche Versprechen endet dort. Der Hook beweist nicht, dass eine Anwendung gesund ist, erkennt keinen ausgeschalteten Host, garantiert keine Webhook-Zustellung und entscheidet nicht, welcher Fehler jemanden wecken sollte. Er ist ein Glied in einer Observability-Kette: präzise genug, um einen lokalen Fehler weiterzuleiten, einfach genug für einen Test und begrenzt genug, dass externes Monitoring weiterhin eine klare Aufgabe hat.
References
- systemd.unit: Unit Configuration — systemd project.
- systemd.service: Service Unit Configuration — systemd project.
- systemctl: Control the systemd System and Service Manager — systemd project.
- systemd-analyze: Analyze and Debug the System Manager — systemd project.
- journalctl: Print Log Entries from the systemd Journal — systemd project.
- systemd.unit(5), Debian bookworm — Debian Manpages, systemd 252.36.