SSRF-Schutz in kleinen PHP-Anwendungen - Eine gültige URL ist kein sicheres Ziel
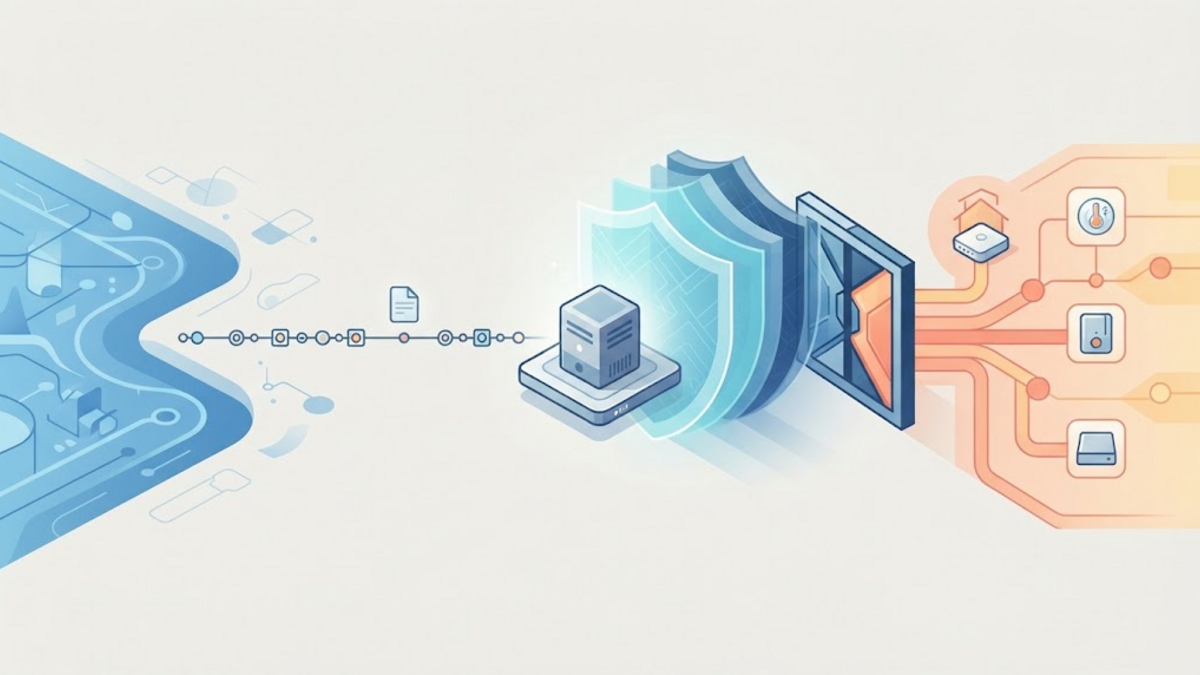
Eine kleine PHP-Anwendung muss vielleicht ein Bild importieren, eine Linkvorschau erzeugen, einen Webhook-Endpunkt testen oder einen externen Feed abrufen. Die Funktion klingt harmlos: eine URL annehmen, eine Anfrage senden und die Antwort verarbeiten. Doch wessen Netzwerkzugriff wird dabei genutzt? Die Anfrage kommt vom Server und nicht aus dem Browser des Besuchers. Dadurch kann sie Ziele erreichen, die für den Besucher selbst nicht erreichbar sind.
Genau an dieser Grenze entsteht Server-Side Request Forgery, kurz SSRF. Das Problem besteht nicht einfach darin, dass eine Eingabe „wie eine URL aussieht“. Es entsteht, wenn nicht vertrauenswürdige Eingaben einen Netzwerk-Client beeinflussen, ohne dass zuverlässig entschieden wurde, wohin dieser Client eine Verbindung aufbauen darf. Auch eine syntaktisch gültige URL kann auf einen Loopback-Dienst, eine private Adresse, einen Link-Local-Endpunkt, ein unerwartetes Protokoll oder einen öffentlichen Host verweisen, der anschließend an ein anderes Ziel weiterleitet.
Dieser Artikel entwickelt ein defensives Prüfmodell für kleine PHP-Anwendungen. Er enthält weder Angriffs-Payloads noch die Behauptung, eine einzelne Validierungsfunktion mache beliebige Abrufe sicher. Sinnvoller ist es, jede Entscheidung zwischen dem Empfang einer Zeichenfolge und dem Aufbau einer Verbindung sichtbar zu machen.
SSRF Nutzt die Position des Servers
MITREs CWE-918 beschreibt SSRF als den Abruf einer übergebenen URL oder ähnlichen Anfrage durch einen Server, ohne ausreichend sicherzustellen, dass die Anfrage das erwartete Ziel erreicht. Diese Formulierung ist wichtig. Der Server kann sich hinter einer Firewall befinden, einen Host mit administrativen Diensten teilen, Zugriff auf privates DNS haben oder Zugangsdaten tragen, die für eine bestimmte Upstream-API gedacht sind. Eine über diesen Server ausgeführte Anfrage übernimmt einen Teil dieser privilegierten Position.
Die mögliche Wirkung beschränkt sich nicht auf das Lesen einer öffentlichen Webseite. Das OWASP SSRF Prevention Cheat Sheet weist darauf hin, dass serverseitige Abrufe interne oder externe Netze, den lokalen Rechner und andere Protokolle als HTTP betreffen können. Die konkrete Auswirkung hängt davon ab, was der Prozess erreichen kann und wie die Antwort das System beeinflussen darf.
Gewöhnliche Funktionen schaffen diese Grenze, ohne wie Sicherheitsfunktionen auszusehen:
- ein Avatar- oder Artikelbild von einer übermittelten URL herunterladen;
- Titel und Vorschaubild für eine Linkvorschau erzeugen;
- Benutzern das Testen eines Webhook-Ziels erlauben;
- Kalender, Feeds oder Dokumente importieren;
- ein Automatisierungswerkzeug eine URL aus externen Inhalten abrufen lassen.
Die erste Designfrage lautet deshalb nicht: „Welcher URL-Validator soll verwendet werden?“ Sie lautet: „Muss diese Funktion überhaupt eine Verbindung zu einem vom Benutzer gewählten Ziel herstellen?“
Eine Gültige URL Ist Kein Autorisiertes Ziel
URL-Syntax und Netzwerkautorisierung beantworten unterschiedliche Fragen. Eine Syntaxprüfung kann feststellen, dass eine Zeichenfolge den Regeln eines Parsers entspricht. Sie stellt nicht fest, ob der Host vertrauenswürdig ist, seine aktuellen Adressen global erreichbar sind, der Port zulässig ist oder das Ziel nach einer Weiterleitung dasselbe bleibt.
In PHP kann dieser Unterschied besonders leicht übersehen werden. Die offizielle Dokumentation zu parse_url() erklärt ausdrücklich, dass die Funktion kein URL-Validator ist. Sie kann unvollständige oder ungültige URLs akzeptieren, folgt keinem einzelnen etablierten URL-Standard und kann Eingaben anders interpretieren als ein anderer Parser. Der letzte Punkt ist entscheidend, wenn eine Komponente einen Host prüft, libcurl oder ein Proxy die tatsächliche Anfrage später aber anders interpretiert.
FILTER_VALIDATE_URL ist zwar ein Validierungsfilter, doch ein erfolgreiches Ergebnis setzt noch keine Zielrichtlinie der Anwendung durch. Die PHP-Dokumentation zu Filtern beschreibt, ob Daten den gewählten Filter passieren. Sie verspricht nicht, dass das resultierende Ziel für einen Server sicher erreichbar ist. Syntaktische Gültigkeit als Autorisierung zu behandeln, wäre so, als würde man die korrekte Schreibweise einer Postadresse prüfen und daraus schließen, dass jedes Gebäude an dieser Adresse für Besucher offensteht.
Eine URL enthält außerdem mehr Struktur als nur einen Hostnamen. RFC 3986 trennt Scheme, Authority, Path, Query und Fragment; Benutzerinformationen, Host und Port befinden sich innerhalb der Authority. Reservierte Zeichen und Percent-Encoding beeinflussen die Interpretation. Eine Sicherheitsentscheidung sollte einen klar definierten Parser verwenden und die geparsten Komponenten vergleichen, statt in der ursprünglichen Zeichenfolge nach einer vertrauenswürdigen Teilzeichenfolge zu suchen.
Die Sicherste URL Wird Oft Gar Nicht vom Benutzer Angegeben
Wenn die Anwendung nur mit einer bekannten API kommuniziert, sollte sie keine vollständige URL annehmen. Stattdessen kann sie einen eng begrenzten fachlichen Bezeichner wie eine Ressourcen-ID akzeptieren und die Anfrage aus einer anwendungseigenen Basis-URL, einem festen Scheme, einem festen Port und kontrolliert kodierten Pfaden zusammensetzen. Das beseitigt deutlich mehr Mehrdeutigkeit als der Versuch, jede gefährliche Form einer allgemeinen URL abzuweisen.
Wenn mehrere Ziele legitim sind, kann eine Allowlist exakte Hosts oder Dienstbezeichner enthalten. Der Vergleich sollte anhand des geparsten und normalisierten Hosts nach einer dokumentierten Richtlinie erfolgen. Eine Suffixprüfung wie „endet mit example.com“ ist nicht gleichbedeutend mit der Auswahl des exakten Hosts api.example.com. Auch Ports und Schemes benötigen eigene Allowlists.
OWASP unterscheidet diesen Fall bekannter Ziele vom deutlich schwierigeren Fall, in dem ein Produkt tatsächlich beliebige öffentliche Ziele erlaubt. Das ist eine wichtige Produktentscheidung. Eine interne Integration, ein Webhook-Tester und ein offener Linkvorschau-Dienst haben nicht dieselbe Zielrichtlinie. Wenn sich die Anforderungen eingrenzen lassen, ist diese Eingrenzung eine Sicherheitsmaßnahme und nicht nur eine Einschränkung.
Wenn Beliebige Öffentliche URLs Erforderlich Sind
Einige Funktionen können keine kleine Ziel-Allowlist verwenden. Sie benötigen eine vorsichtigere Pipeline, in der jeder Fehler die Anfrage ablehnt, bevor eine Verbindung geöffnet wird.
1. Einmal Nach Einem Expliziten Vertrag Parsen
Das von Runtime und Abruf-Stack verwendete Parsermodell sollte ausgewählt und dokumentiert werden. Fehlerhafte oder mehrdeutige Eingaben sollten abgelehnt und nicht stillschweigend repariert werden. Erforderlich sind eine absolute URL, ein erwartbarer Host und das Fehlen einer Benutzerinformations-Komponente. Nur die für die Funktion benötigten Schemes sollten erlaubt sein, normalerweise https und gegebenenfalls http, wenn es dafür einen dokumentierten Grund gibt. Ebenso sollten nur erwartete Ports zulässig sein.
Diese Prüfung reduziert Mehrdeutigkeiten in der Eingabe, autorisiert das Ziel aber noch nicht.
2. Jede Adressfamilie Auflösen und Alle Antworten Klassifizieren
Ein Hostname ist nicht der Endpunkt, den die Netzwerkverbindung verwendet. DNS wandelt ihn in eine oder mehrere IPv4- oder IPv6-Adressen um, und diese Antworten können sich ändern. Die Anwendung braucht eine Richtlinie für jede zurückgegebene Adresse, nicht nur für den ersten passenden A-Record.
Nur die bekannten privaten IPv4-Bereiche aus RFC 1918 zu prüfen, reicht nicht aus. Die aktuellen IANA-Register für IPv4 und IPv6 Special-Purpose Address Space enthalten Loopback-, Link-Local-, Shared-, Dokumentations-, Benchmarking-, Unique-Local-, gemappte und weitere besondere Blöcke mit unterschiedlichen Erreichbarkeitseigenschaften. Eine gepflegte IP-Adressbibliothek und eine explizite Prüfung auf „nach der Richtlinie dieser Anwendung global erreichbar“ sind sicherer als eine selbst geschriebene Präfixliste in einem einzelnen Controller.
Dabei entsteht ein schwieriges Zeitproblem. Wenn Anwendungscode einen Hostnamen auflöst, die Antwort genehmigt und anschließend den ursprünglichen Hostnamen an eine andere Komponente übergibt, kann diese Komponente eine neue DNS-Abfrage durchführen und eine andere Adresse erhalten. OWASP behandelt diese Klasse von DNS-Pinning- oder Rebinding-Problemen. Das Schließen der Lücke zwischen Prüfung und Verbindung kann erfordern, die Verbindung an genehmigte aufgelöste Adressen zu binden und gleichzeitig den vorgesehenen Host für HTTP- und TLS-Prüfungen beizubehalten. Die genaue Methode hängt von HTTP-Client, DNS-Resolver, Proxy und Runtime ab. Deshalb wäre ein kurzer universeller PHP-Helper irreführend.
3. Jede Weiterleitung als Neue Anfrage Behandeln
Eine öffentliche URL kann auf ein Ziel weiterleiten, das die ursprüngliche Prüfung abgelehnt hätte. Automatisches Folgen von Weiterleitungen verschiebt die Sicherheitsentscheidung daher hinter die Validierung, wenn nicht jedes neue Ziel erneut dieselben Prüfungen für Scheme, Port, Hostname, DNS und Adresse durchläuft.
libcurl lässt CURLOPT_FOLLOWLOCATION standardmäßig deaktiviert. Wenn Weiterleitungen nicht benötigt werden, ist das Beibehalten dieses Zustands die einfachste Richtlinie. Benötigt die Funktion Weiterleitungen, sollte sie eine kleine Hop-Grenze verwenden und jedes Ziel vor dem Fortfahren prüfen. Eine Beschränkung der Redirect-Protokolle validiert nicht automatisch den weitergeleiteten Host.
4. Protokolle im Netzwerk-Client Begrenzen
Eine Anwendung möchte vielleicht nur Webseiten abrufen, während ihre libcurl-Version viele weitere Protokolle unterstützt. Laut der Dokumentation des curl-Projekts zu CURLOPT_PROTOCOLS_STR sind standardmäßig alle Protokolle erlaubt, mit denen libcurl gebaut wurde. Eine explizite Protokollliste passt das Verhalten des Clients an den Vertrag der Funktion an.
Für Weiterleitungen gibt es mit CURLOPT_REDIR_PROTOCOLS_STR eine separate Kontrolle. Sie dient als Defense in Depth und ersetzt keine Zielprüfung bei jedem Hop. Auch die Runtime-Kompatibilität ist wichtig: Die zeichenfolgenbasierten Optionen wurden in libcurl 7.85.0 hinzugefügt. Deshalb müssen die eingesetzten PHP- und libcurl-Versionen geprüft werden, bevor man sich darauf verlässt.
Eine Zweite Grenze im Netzwerk Einrichten
Anwendungsvalidierung ist detailreicher Code, der mit detailreichen Randfällen umgehen muss. Sie sollte nicht die einzige Barriere zwischen einem URL-Abruf-Worker und allen Diensten auf dem Host oder im lokalen Netz sein. OWASP empfiehlt, Maßnahmen auf Anwendungs- und Netzwerkebene zu kombinieren.
Auf einem kleinen Server kann das bedeuten, URL-Abrufe unter einer eigenen Dienstidentität oder in einem isolierten Worker auszuführen und ausgehende Firewall-Regeln, einen kontrollierten Proxy oder eine Network-Namespace-Richtlinie anzuwenden. Der Worker sollte nur die für seine Aufgabe benötigten Ziele und Ports erreichen können. Administrative Schnittstellen, Datenbankports, lokale Control Sockets und Metadatendienste sollten aus diesem Kontext unerreichbar bleiben.
Egress-Beschränkungen sind nicht automatisch einfach. Öffentliche Ziele können wechselnde Adressbereiche verwenden, DNS kann von einem Proxy verarbeitet werden und derselbe Host kann mehrere Dienste mit unterschiedlichen Anforderungen ausführen. Die Richtlinie muss zum tatsächlichen Verbindungsweg passen. Dennoch verwandelt eine unabhängige Netzwerkgrenze einen einzelnen Parserfehler von unbeschränktem Serverzugriff in eine abgelehnte Verbindung.
Den Abruf Auch Nach Genehmigung des Ziels Begrenzen
Zielprüfungen beantworten, wohin eine Anfrage gehen darf. Sie kontrollieren nicht, wie teuer oder gefährlich die Antwort sein kann. Ein begrenzter Abruf sollte zusätzlich Folgendes festlegen:
- Zeitlimits für Verbindungsaufbau und Gesamtübertragung;
- eine maximale Zahl von Weiterleitungen, vorzugsweise null, wenn sie nicht erforderlich sind;
- eine maximale Antwortgröße, die bereits beim Streaming und nicht erst nach dem Puffern durchgesetzt wird;
- akzeptierte Content Types und einen sicheren Parser für das erwartete Format;
- Grenzen für Dekomprimierung und nachgelagerte Bild- oder Dokumentverarbeitung;
- ob Antwortkörper gespeichert, angezeigt oder verworfen werden.
Umgebungsabhängige Zugangsdaten, Cookies oder beliebige eingehende Header dürfen nicht an einen vom Benutzer gewählten Host weitergegeben werden. libcurl dokumentiert eine besondere Behandlung für Authorization- und explizit gesetzte Cookie-Header beim Hostwechsel. Es warnt jedoch auch davor, dass andere benutzerdefinierte Header Daten enthalten können, die nicht an einen weitergeleiteten Server gelangen sollten. Die ausgehende Anfrage sollte mit einem minimalen Header-Satz aufgebaut werden.
Eine abgerufene Antwort darf nicht direkt in eine HTML-Seite gespiegelt oder als vertrauenswürdige Anwendungsinformation behandelt werden. SSRF-Prävention kontrolliert das Anfrageziel; Output Encoding, Dateivalidierung, Parser-Härtung und Malware-Richtlinien sind eigenständige Grenzen.
Den Vollständigen Entscheidungsweg Prüfen
Eine hilfreiche Prüfung verfolgt den Wert durch das System und nicht nur einen einzelnen Funktionsaufruf:
- Alle Stellen identifizieren, an denen nicht vertrauenswürdige Daten eine serverseitige Anfrage beeinflussen können.
- Prüfen, ob ein fachlicher Bezeichner oder ein festes Ziel eine vollständige URL ersetzen kann.
- Erlaubte Schemes, exakte Ziele oder die Richtlinie für öffentliche Adressen, Ports und Redirect-Verhalten definieren.
- Sicherstellen, dass Validierung und Abruf dieselbe URL-Interpretation verwenden.
- Alle IPv4- und IPv6-Auflösungsergebnisse prüfen und die Lücke zwischen Genehmigung und Verbindung schließen.
- Die Richtlinie bei jeder Weiterleitung erneut anwenden.
- Client-Protokolle einschränken und eine unabhängige Egress-Grenze hinzufügen.
- Zeit, Datenmenge, Weiterleitungen, Parsing und gespeicherte Daten begrenzen.
- Richtlinienergebnis, Zielklasse, Dauer und Fehlergrund protokollieren, ohne Zugangsdaten oder sensible Antwortkörper zu speichern.
Tests sollten direkte IP-Literale, IPv4 und IPv6, mehrere DNS-Antworten, nicht erlaubte Ports und Schemes, Weiterleitungen zu abgelehnten Zielen, Resolver-Änderungen zwischen Prüfungen, übergroße und komprimierte Antworten, Timeouts sowie Deployments mit Proxy umfassen. Das sind Tests der eigenen Anwendungsrichtlinie und keine Behauptung, dass eine endliche Testsammlung jede URL-Interpretation abdeckt.
Fazit
SSRF-Prävention beginnt mit der Erkenntnis, dass ein serverseitiger Abruf eine Autorisierungsentscheidung ist. Eine URL kann syntaktisch vollkommen gültig sein und den Server trotzdem auffordern, eine Grenze zu überschreiten, die der Benutzer nicht direkt überschreiten könnte.
Das stärkste Design für eine kleine Anwendung vermeidet beliebige URLs und erstellt Anfragen für bekannte Ziele. Wenn der offene Abruf öffentlicher Inhalte wirklich erforderlich ist, reicht kein einzelner Parser, Filter oder keine einzelne Denylist aus. Parsing, Adressauflösung, Redirect-Behandlung, Protokollgrenzen, Ressourcenlimits und Netzwerk-Egress-Kontrollen müssen dieselbe Richtlinie durchsetzen.
Diese mehrschichtige Antwort ist weniger bequem als ein einzeiliger Validator, aber ehrlicher. Die abschließende Frage für eine URL-Abruffunktion lautet nicht nur: „Ist diese URL gültig?“ Sie lautet: „Welche Belege zeigen im Moment jeder Verbindung, dass dieser Prozess dieses Ziel erreichen darf?“
References
- MITRE CWE, “CWE-918: Server-Side Request Forgery (SSRF),” CWE 4.20, updated April 30, 2026.
- OWASP Cheat Sheet Series, “Server-Side Request Forgery Prevention Cheat Sheet”.
- T. Berners-Lee, R. Fielding, and L. Masinter, RFC 3986: Uniform Resource Identifier (URI): Generic Syntax, January 2005.
- PHP Documentation Group, “parse_url”.
- PHP Documentation Group, “filter_var”.
- curl project, “CURLOPT_PROTOCOLS_STR explained”.
- curl project, “CURLOPT_REDIR_PROTOCOLS_STR explained”.
- curl project, “CURLOPT_FOLLOWLOCATION explained”.
- IANA, “IPv4 Special-Purpose Address Space,” updated October 9, 2025.
- IANA, “IPv6 Special-Purpose Address Space,” updated October 9, 2025.