Hook OnFailure systemd untuk Home Server - Arahkan Kegagalan tanpa Menyebutnya Monitoring
Sebuah service gagal pukul 02.00, meninggalkan penjelasan yang berguna di journal, lalu tidak diketahui sampai seseorang membutuhkannya keesokan pagi. Restart policy mungkin memulihkan proses tersebut, tetapi pemulihan dan visibilitas adalah dua pertanyaan berbeda. Bagaimana sebuah home server kecil dapat membuat jalur yang jelas dari “unit ini gagal” menuju “catat atau laporkan kejadian ini” tanpa berpura-pura bahwa jalur tersebut adalah sistem monitoring yang lengkap?
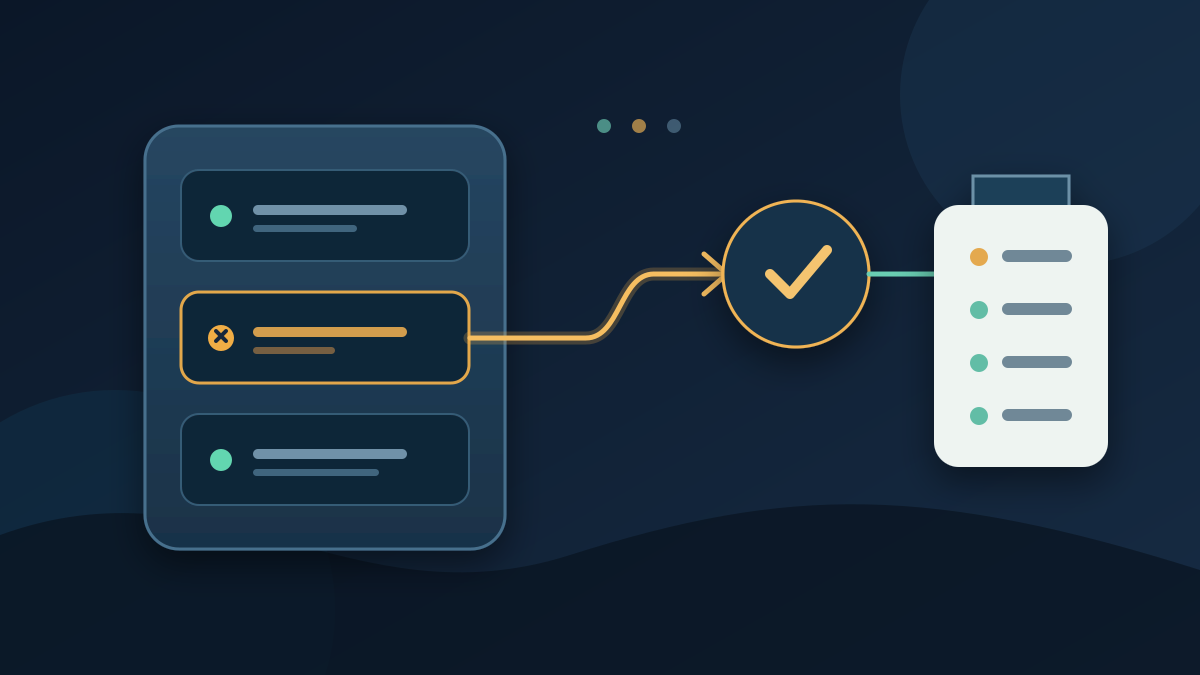
systemd menyediakan satu building block ringkas untuk jalur itu: OnFailure=. Directive ini tidak mengirim email atau memanggil webhook dengan sendirinya. Menurut dokumentasi resmi systemd.unit, directive tersebut mengaktifkan satu atau beberapa unit yang disebutkan ketika unit sumber masuk ke state failed. Batas yang tepat inilah yang membuat fitur tersebut berguna, sekaligus mencegahnya menjadi solusi alerting universal.
Mulai dari transisi state, bukan channel notifikasi
Sebuah unit systemd dapat berada dalam state active, inactive, failed, atau state transisi. Manual systemctl menjelaskan failed sebagai state yang serupa dengan inactive, tetapi unit tersebut gagal karena suatu hal, misalnya error exit, crash, timeout, atau terlalu banyak percobaan restart. Penyebab pastinya tetap bergantung pada tipe unit dan konfigurasinya.
OnFailure= merespons state tersebut. systemctl stop yang berjalan normal biasanya membuat service menjadi inactive, bukan failed, sehingga itu bukan pengujian alert. Unit yang dilewati karena pemeriksaan Condition...= tidak terpenuhi juga belum tentu gagal. Perbedaan ini penting: alert untuk setiap unit inactive akan mengubah shutdown normal dan service yang sengaja tidak aktif menjadi noise.
Ada baiknya memisahkan tiga pekerjaan:
- Detection: systemd memutuskan bahwa unit sumber masuk ke state
failed. - Routing:
OnFailure=meminta systemd mengaktifkan unit handler. - Delivery: handler mencatat kejadian secara lokal atau meneruskannya ke channel eksternal.
Hanya dua pekerjaan pertama yang disediakan oleh OnFailure=. Mail server, API chat, atau webhook tetap bisa tidak terjangkau. Memisahkan lapisan-lapisan tersebut membuat kegagalan lebih mudah dipahami.
Pasang handler yang dapat dipakai ulang melalui drop-in
Misalkan sebuah service bernama example-app.service. Alih-alih mengedit unit file bawaan package, tambahkan drop-in di /etc/systemd/system/example-app.service.d/failure-hook.conf:
[Unit]
OnFailure=unit-failure@%n.service
Specifier %n akan diubah menjadi nama lengkap unit sumber. Untuk contoh ini, systemd mengaktifkan instance yang sesuai dengan [email protected]. Pengulangan .service terlihat aneh, tetapi bagian pertama termasuk dalam nilai instance dan bagian terakhir adalah suffix milik unit handler.
Sekarang buat template /etc/systemd/system/[email protected]:
[Unit]
Description=Record failure of %i

[Service]
Type=oneshot
ExecStart=/usr/bin/logger --tag=unit-failure Failure hook activated for %i
Di dalam template, %i diubah menjadi nama instance, yaitu example-app.service dalam contoh ini. Contoh tersebut sengaja memakai logger, bukan notifier remote sungguhan. Ini membuktikan bahwa jalur routing berjalan dan meninggalkan jejak lokal. Contoh itu tidak mengekspos credential, tidak bergantung pada provider tertentu, dan tidak menyiratkan bahwa pesan remote telah terkirim.
Handler production dapat mengganti command tersebut dengan notifier kecil yang cakupannya sempit. Interface-nya sebaiknya menerima nama unit, menyusun pesan singkat, menerapkan timeout, dan mengembalikan exit status yang bermakna. Secret tidak seharusnya ditempelkan ke contoh unit publik atau ditanam langsung di command line. Handler juga tidak perlu berjalan sebagai root hanya karena service sumber berjalan sebagai root; berikan hanya identity, file, dan akses jaringan yang dibutuhkan metode delivery-nya.
Verifikasi syntax sebelum meminta PID 1 memakainya
Reload dan pengujian perlu dilakukan secara sengaja. Dokumentasi resmi systemd-analyze verify menyebutkan bahwa command ini dapat melaporkan directive yang tidak dikenal, dependency wajib yang hilang, command yang tidak tersedia, dan beberapa error struktural lain.
sudo systemd-analyze verify \
  example-app.service \
  /etc/systemd/system/[email protected]
sudo systemctl daemon-reload
systemctl cat example-app.service
Jika unit sumber berasal dari package, periksa unit efektif beserta drop-in-nya dengan systemctl cat. Hasil verifikasi yang bersih berguna, tetapi terbatas: hasil tersebut tidak dapat membuktikan bahwa DNS bekerja, API token valid, penerima ada, atau service remote menerima pesan. Validasi syntax dan pengujian delivery adalah dua gate berbeda.
Uji dengan kegagalan disposable
Merusak web server sungguhan untuk menguji alert adalah perjudian yang tidak perlu. Unit test sementara dapat menjalankan transisi state tanpa menyentuh aplikasi. Simpan konfigurasi berikut sebagai /etc/systemd/system/failure-hook-test.service dan berikan hook yang sama:
[Unit]
Description=Disposable failure-hook test
OnFailure=unit-failure@%n.service

[Service]
Type=oneshot
ExecStart=/usr/bin/false
Setelah menjalankan daemon-reload lagi, mulai pengujian dan periksa kedua sisinya:
sudo systemctl start failure-hook-test.service
systemctl status failure-hook-test.service --no-pager
systemctl status [email protected] --no-pager
journalctl -u failure-hook-test.service --no-pager
journalctl -u [email protected] --no-pager
journalctl -t unit-failure --no-pager
Command pertama memang diharapkan mengembalikan kegagalan karena /usr/bin/false keluar dengan status tidak sukses. Hasil non-zero itu adalah bagian dari pengujian, bukan bukti bahwa hook dilewati. Status dan journal unit sumber seharusnya menjelaskan kegagalan sumber; status handler dan entri journal dengan tag tersebut seharusnya menunjukkan apakah unit sekunder berjalan. Dokumentasi journalctl -u menyebutkan bahwa filter ini menyertakan pesan yang dikeluarkan oleh dan tentang unit yang dipilih.
Setelah mencatat hasilnya, hapus unit disposable, reload manager, dan bersihkan failure yang diingat:
sudo systemctl reset-failed failure-hook-test.service
sudo rm /etc/systemd/system/failure-hook-test.service
sudo systemctl daemon-reload
reset-failed menghapus state failed dan juga mereset counter start-limit serta restart per unit. Ini adalah cleanup, bukan diagnosis; baca journal sebelum menghapus runtime state yang berguna.
Restart policy dan failure routing adalah kontrol yang berbeda
Restart=on-failure menanyakan apakah systemd perlu mencoba menjalankan service kembali. OnFailure= menanyakan apakah unit lain perlu diaktifkan ketika sumber mencapai state failed. Sebuah service dapat pulih setelah satu restart tetapi kejadiannya tetap layak dicatat, sedangkan service yang terus gagal pada akhirnya dapat mencapai start limit. Dokumentasi systemd.service menjelaskan penyebab restart dan rate limiting; kedua setting tersebut tidak seharusnya dipakai untuk menyembunyikan failure loop yang belum diselesaikan.
Ada pula pengecualian yang bergantung pada versi. RestartMode=direct, yang ditambahkan pada systemd 254, melewati transisi failed/inactive selama automatic restart sehingga juga melewati OnFailure= untuk percobaan tersebut. Dokumentasi systemd 252 milik Debian bookworm belum mencantumkan mode yang lebih baru itu, sedangkan dokumentasi upstream saat ini mencantumkannya. Periksa systemctl --version dan konfigurasi efektif service daripada menganggap setiap host mengikuti manual terbaru.
Rancang dengan asumsi bahwa handler juga bisa gagal
Handler berada di mesin yang sama dengan masalah yang dilaporkannya. Jika disk penuh, name resolution rusak, jaringan terputus, atau host kehilangan daya, handler mungkin tidak dapat mengirim apa pun. Entri journal lokal tetap berguna untuk diagnosis belakangan, tetapi tidak dapat memberi tahu seseorang mengenai mesin yang sama sekali tidak terjangkau. External uptime check mengamati dari failure domain lain dan tetap diperlukan ketika ketiadaan host itu sendiri harus terdeteksi.
Crash berulang menimbulkan masalah lain: terlalu banyak pesan. Start-rate limit systemd dapat membatasi percobaan restart service, tetapi notifier mungkin tetap memerlukan kebijakan deduplication atau cooldown sendiri. Event yang berguna sebaiknya mengidentifikasi host, unit, waktu, dan sebuah result field kecil yang stabil; event tersebut sebaiknya menautkan atau menunjuk ke log, bukan menyalin journal tanpa batas ke setiap pesan. Hindari menyertakan environment variable atau command line secara sembarangan karena keduanya mungkin berisi credential.
Unit handler itu sendiri juga harus observable. Periksa dengan systemctl --failed, baca journal-nya, dan uji channel delivery yang sebenarnya secara berkala. Service sumber yang hijau tidak membuktikan bahwa credential notifier dari bulan lalu masih bekerja. Sebaliknya, notifier yang gagal tidak seharusnya me-restart atau menghentikan aplikasi yang hendak dilaporkannya; jalur pelaporan perlu tetap menjadi side channel, bukan hard dependency baru.
Gunakan hook untuk janji yang sempit
OnFailure= adalah mekanisme kecil dengan kontrak yang berguna: ketika systemd mencatat transisi nyata menuju state failed, systemd dapat mengaktifkan unit lain. Drop-in per service, template yang dapat dipakai ulang, jejak journal lokal, dan pengujian disposable sudah cukup untuk membuat kontrak tersebut terlihat.
Janji yang jujur berhenti sampai di sana. Hook tidak membuktikan aplikasi sehat, tidak mendeteksi host yang mati, tidak menjamin webhook tiba, dan tidak memutuskan kegagalan mana yang layak membangunkan seseorang. Perlakukan fitur ini sebagai satu mata rantai dalam observability chain: cukup presisi untuk mengarahkan kegagalan lokal, cukup sederhana untuk diuji, dan cukup terbatas sehingga external monitoring tetap memiliki tugas yang jelas.
References
- systemd.unit: Unit Configuration — systemd project.
- systemd.service: Service Unit Configuration — systemd project.
- systemctl: Control the systemd System and Service Manager — systemd project.
- systemd-analyze: Analyze and Debug the System Manager — systemd project.
- journalctl: Print Log Entries from the systemd Journal — systemd project.
- systemd.unit(5), Debian bookworm — Debian Manpages, systemd 252.36.