RAG untuk Aplikasi AI Kecil - Mengambil Bukti Tanpa Menganggapnya sebagai Kebenaran
RAG untuk Aplikasi AI Kecil - Mengambil Bukti Tanpa Menganggapnya sebagai Kebenaran
Ketika language model menjawab pertanyaan tentang dokumen pribadi, manual produk, atau kebijakan internal yang terus berubah, ada jarak yang tidak nyaman antara apa yang model ketahui dan apa yang perlu diketahui aplikasi. Retrieval-augmented generation (RAG) adalah salah satu cara untuk memperkecil jarak itu. Namun, retrieval bukan mesin kebenaran. Retrieval adalah cara menempatkan materi yang dipilih di hadapan model, dengan semua risiko yang muncul dari proses pemilihan dan penafsirannya.
Pembedaan ini penting untuk aplikasi AI kecil. Kita mudah tergoda memulai dari vector database lalu menjanjikan jawaban yang bersumber dari dokumen perusahaan. Titik awal yang lebih berguna adalah beberapa pertanyaan: dokumen mana yang boleh digunakan, bagaimana bagian yang relevan akan ditemukan, apa yang terjadi ketika tidak ada bagian yang relevan, dan bagaimana kita tahu ketika sistem salah?
Apa yang Ditambahkan RAG ke Language Model
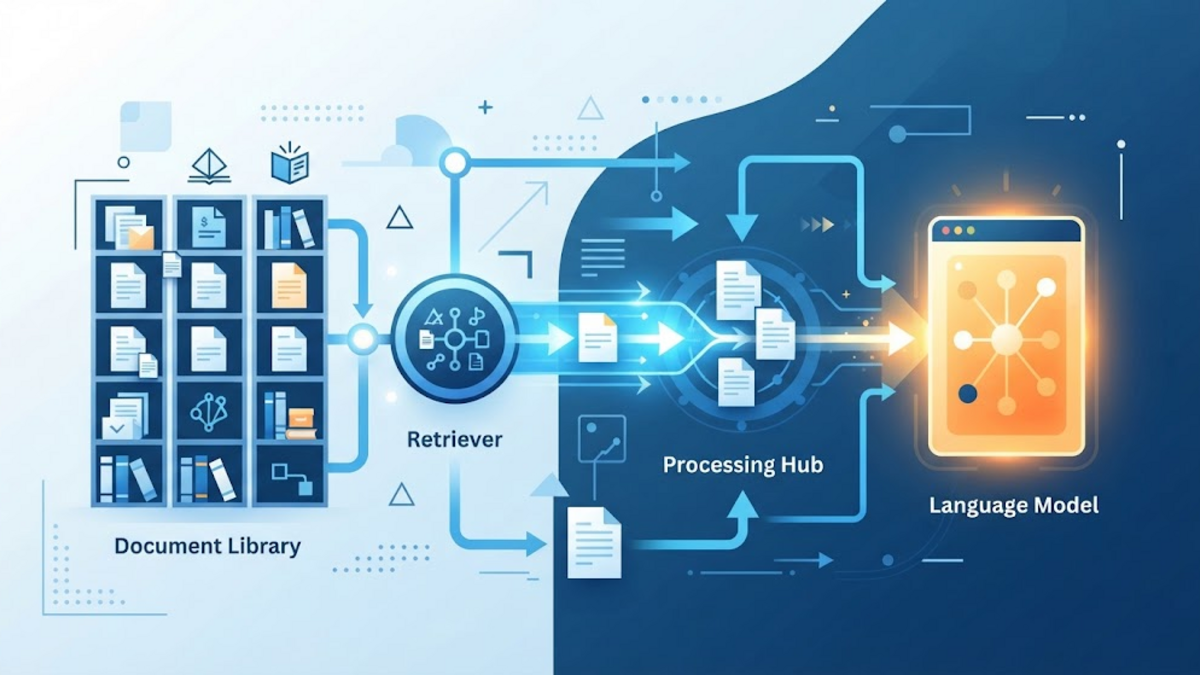
Language model memiliki pengetahuan yang direpresentasikan dalam parameternya. RAG menambahkan koleksi materi eksternal yang dapat dicari saat permintaan diproses. Paper RAG oleh Lewis dan rekan-rekannya menjelaskan model yang menggabungkan parametric memory dengan non-parametric memory: retriever mengakses dense vector index, lalu generator menggunakan materi yang diambil ketika menghasilkan jawaban.
Dalam aplikasi kecil, koleksi eksternal itu bisa berupa halaman bantuan, export database, atau file Markdown yang dipilih dengan hati-hati. Model tidak secara ajaib menyerap file tersebut sebagai pengetahuan permanen. Aplikasi mengambil beberapa bagian untuk pertanyaan tertentu dan memasukkannya ke input model.
Hal itu membuat RAG berbeda dari fine-tuning. Fine-tuning mengubah perilaku atau parameter model melalui pelatihan tambahan. RAG biasanya membiarkan parameter model tetap sama dan mengubah context yang diberikan saat inference. Keduanya dapat digabungkan, tetapi menyelesaikan masalah yang berbeda.
Pipeline-nya Lebih dari Sekadar Vector Search
Dokumentasi sering menggambarkan RAG sebagai rangkaian yang rapi, tetapi setiap tahap dapat gagal secara terpisah. Cara berpikir yang praktis memiliki lima tahap.
1. Memuat materi sumber
Pertama, tentukan file, halaman, record, atau API response mana yang menjadi bagian corpus. Loading bukan detail administratif. Jika policy lama, draft, dan policy terbaru masuk tanpa metadata, retrieval bisa menemukan versi yang salah dan tetap terlihat masuk akal.
Aturan akses juga termasuk di sini. Passage yang diambil tidak boleh membocorkan dokumen yang tidak boleh dibaca oleh user yang meminta. Memfilter hanya setelah generation sudah terlambat: model telah melihat context yang seharusnya dibatasi.
2. Memecah dan mengindeks materi
Dokumen panjang biasanya dibagi menjadi beberapa chunk. Setiap chunk dapat direpresentasikan sebagai embedding, yaitu representasi numerik yang dimaksudkan untuk menangkap aspek tertentu dari maknanya. Embedding disimpan dalam index agar query dapat menemukan materi yang berdekatan.
Tidak ada ukuran chunk yang selalu benar. Chunk yang terlalu kecil bisa kehilangan kondisi yang memberi makna pada sebuah kalimat. Chunk yang terlalu besar bisa memuat beberapa topik yang tidak berkaitan dan menghabiskan lebih banyak context. Heading, document identifier, tanggal, access label, dan link sering sama pentingnya dengan teksnya.
Paper Dense Passage Retrieval menjelaskan pendekatan dual-encoder untuk mempelajari representasi dense dari pertanyaan dan passage. Ini adalah latar belakang yang berguna untuk memahami mengapa embedding dapat mengambil passage yang berhubungan secara semantik, tetapi hasil benchmark di dalamnya bukan jaminan untuk corpus, bahasa, model, atau aplikasi yang berbeda.
3. Menyimpan index dan metadata
Index hanyalah salah satu bagian dari state yang disimpan. Hasil yang berguna tetap harus menunjuk ke dokumen sumber dan lokasinya. Simpan metadata yang cukup untuk menerapkan authorization, memfilter berdasarkan versi atau tanggal, dan menampilkan citation yang bermakna. Tanpa hubungan itu, sistem bisa menghasilkan teks yang lancar tetapi menyulitkan pemeriksaan materi yang memengaruhi jawaban.
4. Mengambil materi untuk sebuah pertanyaan
Saat query dijalankan, aplikasi mengubah pertanyaan menjadi permintaan pencarian. Dense retrieval dapat menemukan wording yang berhubungan meskipun hanya sedikit keyword yang sama. Dokumentasi OpenAI Retrieval, misalnya, menjelaskan semantic search pada vector store, batas jumlah hasil, score, metadata filter, dan optional query rewriting.
Keyword search bukan sesuatu yang usang. Nama produk, error code, version number, dan exact identifier bisa tidak dilayani dengan baik oleh semantic similarity saja. Strategi hybrid dapat menggabungkan lexical matching dengan embedding, dan reranker dapat menyusun ulang kandidat. Semua itu adalah pilihan desain, bukan bukti bahwa hasilnya benar.
5. Menghasilkan jawaban dan mengevaluasi
Passage yang dipilih dan pertanyaan asli menjadi context untuk language model. Model kemudian menulis jawaban. Ini adalah tahap generation, bukan database query yang mengembalikan fakta terverifikasi. Model bisa salah memahami passage, menggabungkan dua passage yang bertentangan, atau menjawab melampaui dukungan context.
LlamaIndex menjelaskan loading, indexing, storing, querying, dan evaluation sebagai tahap yang berbeda. Pemisahan ini berguna karena “jawabannya terdengar bagus” bukan metode evaluasi. Test set kecil sebaiknya mencakup pertanyaan biasa, pertanyaan yang jawabannya tidak ada, pertanyaan ambigu, kasus dokumen kedaluwarsa, dan kasus access control.
Tiga Cara Berbeda RAG Bisa Salah
Retriever menemukan passage yang salah
Search result bisa berkaitan secara topik tetapi gagal menjawab pertanyaan. Misalnya, sebuah dokumen menjelaskan cara merotasi credential, sedangkan pertanyaannya adalah apakah user tertentu boleh melakukannya. Kata-katanya berhubungan; aturan authorization-nya berbeda.
Corpus tidak memuat jawabannya
Retrieval tidak bisa menemukan informasi yang tidak pernah dimuat atau telah dihapus saat preprocessing. Aplikasi yang bertanggung jawab memerlukan jalur abstention: “Aku tidak menemukan dukungan dalam dokumen yang diberikan” lebih jujur daripada mengisi kekosongan dari general memory model.
Generator melebih-lebihkan bukti
Passage yang relevan pun bisa bersyarat, bertentangan, atau tidak lengkap. Meminta model menyertakan source identifier dapat meningkatkan inspectability, tetapi citation tidak otomatis membuktikan bahwa sebuah kalimat didukung oleh sumber tersebut. Menampilkan citation dan memverifikasi fakta adalah dua hal yang berbeda.
Desain Kecil yang Dapat Dipertanggungjawabkan
Untuk aplikasi kecil, versi pertama boleh sengaja sederhana. Simpan corpus berversi, berikan stable identifier dan access label pada setiap chunk, ambil kandidat dalam jumlah terbatas, lalu kirim identifier-nya bersama teks. Instruksikan model untuk menjawab hanya dari context yang diberikan dan menyatakan jika context tidak cukup. Setelah itu, catat pertanyaan, identifier yang diambil, jawaban model, dan penilaian reviewer dengan privacy control yang sesuai.
Ini bukan security boundary dengan sendirinya. Dokumen yang tidak tepercaya dapat berisi instruksi yang ditujukan kepada model, data sensitif dapat diambil untuk user yang salah, dan log dapat menjadi sumber kebocoran kedua. Artikel sebelumnya tentang prompt injection telah membahas mengapa instruction bukan security boundary; RAG menambahkan jalur input lain yang harus diperlakukan dengan kehati-hatian yang sama.
Evaluation setidaknya harus mengukur relevance retrieval dan kualitas jawaban secara terpisah. Tanyakan apakah sumber yang diharapkan berhasil diambil, apakah response didukung oleh teks yang diambil, apakah sistem melakukan abstention ketika bukti tidak ada, dan apakah permission dihormati. AI Risk Management Framework dari NIST cakupannya lebih luas daripada RAG, tetapi penekanannya pada pengelolaan dan evaluasi risiko AI mengingatkan bahwa satu komponen tidak membuat seluruh sistem tepercaya.
Apa yang Tidak Dijanjikan RAG
- RAG tidak membuat corpus yang kedaluwarsa menjadi terbaru.
- RAG tidak menjamin hasil teratas relevan.
- RAG tidak mengubah dokumen yang tidak tepercaya menjadi instruction yang tepercaya.
- RAG tidak menghapus kebutuhan akan access control, testing, atau human review untuk keputusan berkonsekuensi.
- RAG tidak membuat jawaban model setara dengan kutipan dari sumbernya.
Kesimpulan
RAG paling tepat dipahami sebagai pipeline retrieval-and-generation, bukan tombol yang mengubah language model menjadi database. Sumbangan utamanya adalah memberikan context eksternal yang dipilih kepada model ketika pertanyaan diajukan. Pekerjaan sulitnya adalah menentukan apa yang masuk corpus, apa yang diambil, siapa yang boleh melihatnya, bagaimana bukti yang hilang ditangani, dan bagaimana kegagalan diukur.
Untuk aplikasi AI kecil, sudut pandang yang sederhana ini justru menjadi kekuatan. Sebelum membandingkan vector database, buat batas bukti menjadi jelas dan susun test di sekitar kegagalan yang ingin ditemukan. Pertanyaan akhirnya bukan sekadar apakah model bisa menjawab, melainkan apakah aplikasi dapat menjelaskan mengapa jawaban itu diizinkan.
References
- Patrick Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv, revised April 12, 2021.
- Vladimir Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering, Association for Computational Linguistics, EMNLP 2020.
- OpenAI, Retrieval, official documentation, publication date not stated.
- LlamaIndex, Introduction to RAG, official documentation, publication date not stated.
- National Institute of Standards and Technology, AI Risk Management Framework, released January 26, 2023.