Regression Eval untuk Workflow LLM Kecil - Uji Perubahannya, Bukan Demonya
Sebuah prompt direvisi, model yang lebih baru dipilih, atau pengaturan retrieval disesuaikan. Beberapa output pertama terlihat lebih rapi daripada sebelumnya. Apakah workflow itu benar-benar lebih baik, atau demonstrasinya hanya kebetulan menghindari kasus yang justru memburuk?
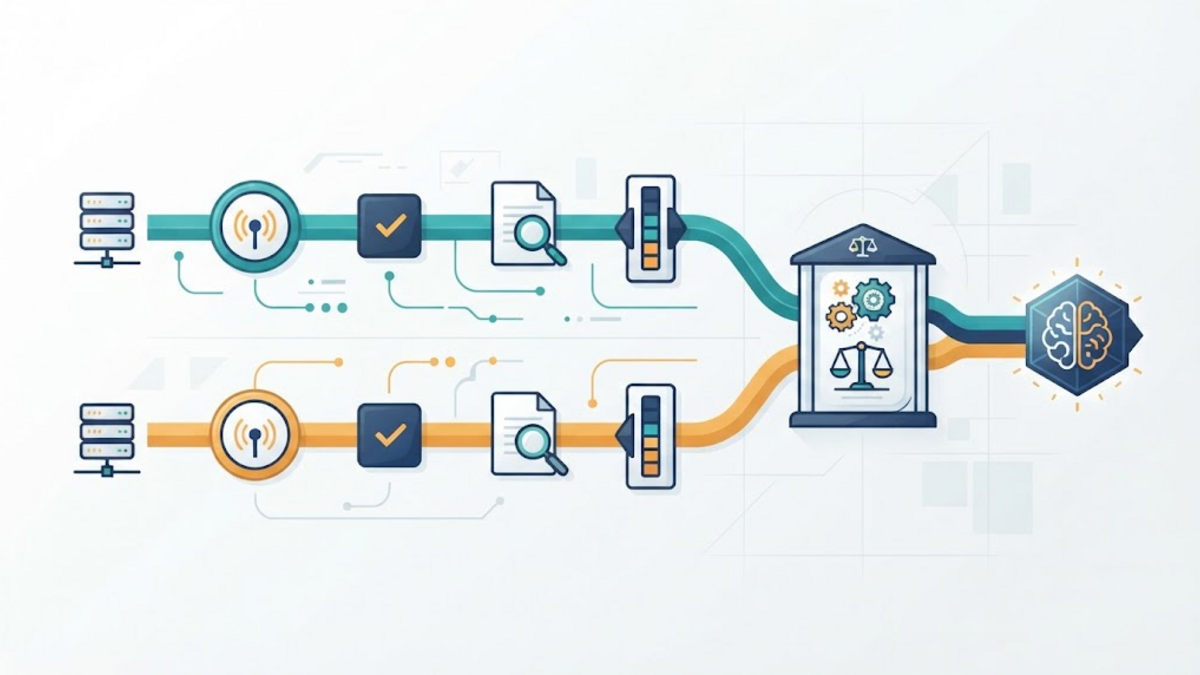
Inilah peran praktis regression eval: menjalankan perubahan kandidat dan baseline saat ini terhadap persyaratan yang sama, lalu memeriksa perilaku mana yang membaik, tetap dapat diterima, atau mengalami regresi. Pendekatan ini lebih dekat dengan pemeriksaan rilis yang dapat diulang daripada leaderboard model publik. Janjinya juga sengaja terbatas. Eval dapat mengungkap kegagalan yang terwakili oleh kasus dan grader-nya; eval tidak dapat membuktikan bahwa aplikasi LLM benar atau aman dalam setiap situasi.
Evaluasi workflow, bukan reputasi model
Benchmark model menanyakan bagaimana performa sistem pada kumpulan tugas standar. Eval aplikasi menanyakan apakah satu workflow tertentu melakukan pekerjaannya dalam kondisi yang penting bagi penggunanya. Kedua pertanyaan itu saling bersinggungan, tetapi tidak dapat saling menggantikan.
Sebagai contoh, asisten penerbitan mungkin perlu mempertahankan URL sumber, melakukan abstention ketika bukti tidak tersedia, menjaga caveat selama penerjemahan, dan tidak mengusulkan publikasi ketika file wajib belum ada. Skor model umum tidak secara langsung menguji batas-batas tersebut. Unit yang diuji mencakup developer instruction, model dan parameternya, konteks hasil retrieval, tool, kode aplikasi, serta pemeriksaan output yang bersama-sama menghasilkan hasil yang terlihat.
Panduan evaluasi OpenAI merekomendasikan evaluasi yang spesifik terhadap tugas dan mengidentifikasi titik ketidakpastian yang berbeda dalam satu panggilan model, workflow, dan agent. Pemisahan itu tetap berguna tanpa memakai tool OpenAI. Jika sebuah workflow mengekstrak ID artikel, mengambil record, dan menyusun response, ujilah ekstraksi, retrieval, dan jawaban akhir secara terpisah jika memungkinkan. Kegagalan end-to-end kemudian lebih mudah ditemukan daripada satu vonis bahwa “AI gagal.”
Ubah ekspektasi menjadi kriteria yang dapat diamati
“Jawabannya harus bagus” belum menjadi sebuah pengujian. Sebelum mengumpulkan kasus, tuliskan apa arti keberhasilan dan kegagalan yang tidak dapat diterima untuk aplikasi ini. Dokumentasi evaluasi Anthropic menjelaskan bahwa kriteria yang berguna bersifat spesifik, terukur, dapat dicapai, dan relevan, sekaligus mencatat bahwa kebanyakan aplikasi memerlukan beberapa dimensi.
Untuk workflow riset dan penulisan kecil, scorecard-nya dapat menanyakan:
- Apakah klaim faktual didukung oleh sumber yang disediakan?
- Apakah output menyatakan bahwa bukti tidak cukup ketika corpus tidak memuat jawaban?
- Apakah kutipan, URL, tanggal, dan code dipertahankan persis ketika diwajibkan?
- Apakah terjemahan mempertahankan setiap paragraf dan caveat tanpa menambahkan klaim baru?
- Apakah router hanya memilih tool yang diizinkan dan mengirimkan identifier stabil yang benar?
- Apakah workflow tetap berada dalam anggaran latency dan biaya?
Kriteria tersebut tidak seharusnya terlalu cepat dilebur menjadi satu nilai rata-rata. Proyek riset HELM mengusulkan evaluasi pada berbagai skenario dan metrik, alih-alih membiarkan accuracy menyembunyikan robustness, fairness, toxicity, efficiency, atau tradeoff lainnya. Aplikasi kecil tidak perlu meniru skala HELM, tetapi dapat mengambil manfaat dari pertanyaan yang sama: dimensi penting mana yang mungkin membaik sementara dimensi lain diam-diam memburuk?
Bangun dataset kecil yang dapat menjadi semakin jujur
Dataset pertama tidak harus sangat besar. Dataset tersebut perlu mudah dipahami, memiliki versi, dan terhubung dengan pekerjaannya. Setiap kasus dapat mencatat input, konteks yang relevan, perilaku yang diharapkan, aturan penilaian, dan alasan singkat mengapa kasus itu ada.
Kumpulan awal yang seimbang perlu mencakup lebih dari sekadar contoh yang berhasil:
- Kasus biasa: request representatif yang memang diharapkan dapat ditangani workflow.
- Kasus batas: input panjang, field yang hilang, request ambigu, format yang tidak biasa, dan bahasa yang didukung.
- Kasus negatif: request yang seharusnya ditolak, ditunda, atau dijawab dengan “bukti tidak cukup.”
- Kegagalan yang telah diketahui: insiden yang sudah ditinjau dan sebelumnya menghasilkan routing yang salah, klaim tanpa dukungan, caveat yang hilang, atau output malformed.
- Kasus kontrol: contoh sederhana yang seharusnya tetap stabil dan dapat segera memperlihatkan test harness yang rusak.
Dataset yang hanya dibuat dari contoh rekaan dapat melewatkan bentuk input yang muncul dalam penggunaan nyata. Log dan feedback pengguna dapat menyediakan kasus yang lebih baik, tetapi mungkin mengandung data pribadi, secret, materi berhak cipta, atau input berbahaya. Minimalkan dan lakukan redaction pada record, batasi akses, dokumentasikan alasan setiap kasus disimpan, dan dapatkan persetujuan apa pun yang diwajibkan konteksnya. “Catat semuanya” bukan izin untuk membuat arsip prompt tanpa batasan.
Sisihkan sebagian kasus yang sudah ditinjau dari proses tuning prompt sehari-hari. Jika setiap kegagalan selalu terlihat saat prompt diedit, workflow dapat mempelajari susunan kata pada pengujian tanpa menjadi lebih andal pada input yang mirip. Held-out set tidak menghilangkan kontaminasi, tetapi menciptakan perbandingan akhir yang lebih bermakna.
Sesuaikan grader dengan klaimnya
Tidak setiap output memerlukan model lain untuk menilainya. Gunakan grader dengan ambiguitas paling rendah yang dapat menguji persyaratan tersebut.
Pemeriksaan deterministik
Kode biasa cocok untuk properti yang pasti: JSON valid, key wajib, nilai enum yang diizinkan, URL yang tetap utuh, jumlah paragraf, nama tool terlarang, atau kesamaan antara ID record yang diharapkan dan yang sebenarnya. Pemeriksaan ini cepat dijalankan ulang dan mudah dijelaskan. Pemeriksaan deterministik tetap dapat mengodekan persyaratan yang salah, tetapi tidak memperkenalkan interpretasi dari model kedua.
Rubrik manusia
Manusia dibutuhkan ketika relevansi, kejelasan, kualitas terjemahan, dukungan bukti, atau tingkat keparahan tidak dapat direduksi secara jujur menjadi perbandingan string. Rubrik perlu mendefinisikan setiap kriteria dan memperlihatkan contoh di sekitar batas keputusan. Reviewer dapat berbeda pendapat, sehingga perbedaan itu sendiri merupakan informasi: hal tersebut mungkin mengungkap rubrik yang tidak jelas, kasus ambigu, atau persyaratan yang sebenarnya belum disepakati tim.
Model grader
Model grader dapat membuat peninjauan berulang terhadap output open-ended lebih terjangkau, terutama untuk perbandingan berpasangan atau rubrik pass/fail yang sempit. Namun, ia tetap merupakan instrumen pengukuran, bukan ground truth. Paper MT-Bench dan Chatbot Arena mempelajari LLM judge dan mengidentifikasi position bias, verbosity bias, self-enhancement bias, serta keterbatasan reasoning. Hasil agreement yang dilaporkan hanya berlaku pada model, prompt, dan data dalam studi tersebut; hasil itu bukan jaminan untuk judge, bahasa, atau domain lain.
Sebelum model grader menjadi release gate, bandingkan keputusannya dengan sekumpulan label dari orang-orang yang bertanggung jawab atas aplikasi tersebut. Selidiki perbedaan, pertegas rubrik, uji pertukaran urutan jawaban untuk penilaian berpasangan, dan periksa ulang kalibrasi ketika model atau prompt judge berubah. Jika grader dan kandidat memiliki blind spot yang sama, skor yang tampak presisi dapat memperkuat masalah alih-alih mengungkapnya.
Bandingkan kandidat dengan baseline yang tetap
Regression run perlu menyimpan konfigurasi yang cukup untuk menjelaskan perbandingan: versi dataset, versi prompt, identifier model, pengaturan retrieval, definisi tool, versi grader, dan revisi aplikasi yang relevan. Jalankan baseline dan kandidat pada kasus yang sama dengan grader yang sama. Jika tidak, perubahan skor mungkin menjelaskan pengujian yang berubah, bukan workflow yang berubah. Hal ini mencerminkan siklus tugas, test input, kriteria, dan analisis hasil yang dijelaskan dalam dokumentasi working with evals dari OpenAI, tanpa bergantung pada interface produknya saat ini.
Catat hasil pada tingkat kasus, bukan hanya total. Kandidat yang meloloskan satu kasus style tambahan tetapi mulai menciptakan sumber dalam kasus negatif tidak seharusnya bersembunyi di balik rata-rata yang sedikit lebih tinggi. Tampilan peninjauan yang berguna antara lain:
- kasus yang berubah dari pass menjadi fail;
- kasus yang berubah dari fail menjadi pass;
- kegagalan dengan severity tinggi berapa pun skor agregatnya;
- perbedaan antar-grader dan label manusia yang tidak pasti;
- perubahan biaya, latency, refusal, dan perilaku penggunaan tool.
Output yang dihasilkan dapat bervariasi meskipun input yang terlihat tidak berubah. Karena itu, run berulang mungkin tepat untuk kasus yang tidak stabil atau memiliki konsekuensi besar, tetapi tidak ada jumlah pengulangan maupun ambang pass yang berlaku universal. Pilihannya bergantung pada konsekuensi kegagalan, variasi yang diharapkan, anggaran, dan konfigurasi workflow. Nyatakan kebijakan tersebut, jangan meminjam angka dari benchmark yang tidak berkaitan.
Buat release gate yang sempit dan eksplisit
Kebijakan rilis dapat menggabungkan beberapa aturan: tidak ada regresi pada pemeriksaan deterministik yang kritis, tidak ada kegagalan baru dengan severity tinggi yang sudah ditinjau manusia, performa yang dapat diterima pada kasus biasa, dan biaya operasional yang terkendali. Gate yang gagal seharusnya menghentikan rollout atau memerlukan keputusan yang terdokumentasi, bukan memicu pengeditan otomatis sampai skornya kebetulan naik.
Gate ini melengkapi kontrol lain. Schema validation tetap memeriksa shape. Authorization tetap membatasi siapa yang boleh bertindak. Human approval mungkin tetap diperlukan sebelum side effect yang memiliki konsekuensi. Monitoring tetap dibutuhkan setelah rilis. NIST Generative AI Profile menempatkan evaluasi dalam risk management sepanjang lifecycle yang lebih luas; dokumen tersebut tidak menjadikan satu skor pra-rilis sebagai pengganti design, oversight, incident response, atau pengukuran berkelanjutan.
Ketika kegagalan produksi yang sudah ditinjau muncul, tambahkan versi yang sudah diminimalkan ke regression set, jelaskan perilaku yang diharapkan, dan pertahankan kasus itu setelah perbaikan langsung selesai. Suite tersebut kemudian menjadi catatan persyaratan dan failure mode yang telah ditemukan, bukan showcase yang hanya dirakit sekali sebelum peluncuran.
Apa yang tidak dibuktikan oleh eval yang lulus
Suite yang lulus berarti konfigurasi yang diuji memenuhi kriteria yang dikodekan pada kasus yang diuji menurut grader yang dipilih. Hasil tersebut tidak menunjukkan bahwa kasusnya mewakili setiap pengguna pada masa depan, bahwa referensinya lengkap, bahwa model judge bebas bias, atau bahwa rangkaian tool yang belum pernah terlihat pasti aman. Eval juga dapat melewatkan kegagalan karena rubriknya tidak pernah mengajukan pertanyaan yang relevan.
Keterbatasan ini bukan alasan untuk kembali mengandalkan intuisi. Ini adalah alasan untuk menjaga klaim tetap sebanding dengan bukti. Regression eval mengganti “demo ini terlihat lebih baik” dengan perbandingan yang dapat ditelusuri. Eval dapat memberi tahu tim kecil perilaku mana yang tetap bertahan setelah perubahan, di mana tradeoff muncul, dan bagian mana yang masih membutuhkan penilaian manusia.
Kesimpulan
Eval yang berguna bukanlah benchmark terbesar atau dashboard paling rumit. Eval yang berguna adalah pengujian terkecil yang dapat diulang, mencerminkan kewajiban nyata workflow, dan membuat kegagalan penting terlihat sebelum rilis. Definisikan kewajiban tersebut, kumpulkan kasus representatif dan sulit, gunakan pemeriksaan deterministik jika memungkinkan, kalibrasikan grader berbasis penilaian, dan bandingkan setiap kandidat dengan baseline yang sama.
Hasilnya bukan kepastian. Hasilnya adalah pertanyaan yang lebih baik pada saat perubahan: bukan “Bisakah versi baru menghasilkan jawaban yang mengesankan?” melainkan “Perilaku wajib mana yang dipertahankan, mana yang diperbaiki, dan bukti apa yang menyatakan bahwa versi ini siap menggantikan sesuatu yang sudah bekerja?”
References
- OpenAI. Evaluation best practices. Live documentation, diakses 1 November 2026.
- OpenAI. Working with evals. Live documentation, diakses 1 November 2026.
- Anthropic. Define success criteria and build evaluations. Live documentation, diakses 1 November 2026.
- Chloe Autio et al. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. NIST AI 600-1, 26 Juli 2024; halaman diperbarui 8 April 2026.
- Percy Liang et al. “Holistic Evaluation of Language Models.” Transactions on Machine Learning Research, 2023.
- Lianmin Zheng et al. “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena.” NeurIPS 2023 Datasets and Benchmarks Track, direvisi 24 Desember 2023.